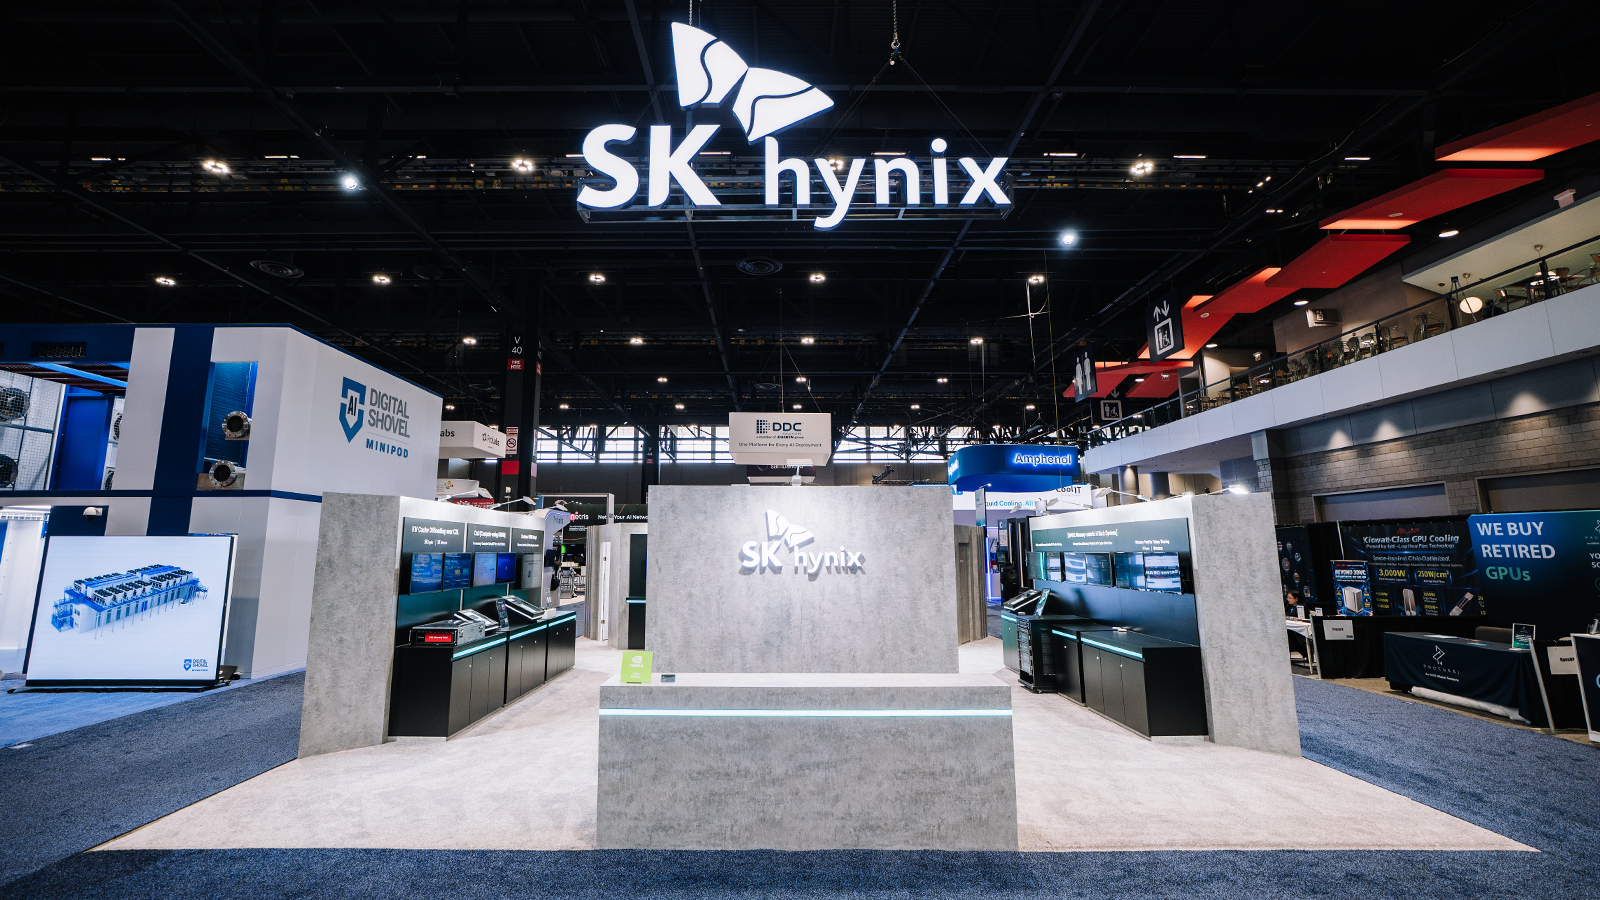
AI가 처리하는 데이터의 양이 늘수록 이를 효과적으로 저장하고 처리하기 위한 메모리 기술의 진화도 빨라지고 있다. 데이터를 저장했다가 필요할 때 가져오는 수준을 넘어, 데이터 사용 빈도에 따라 메모리를 계층화하거나 여러 대의 서버를 하나의 메모리 풀로 묶어 스토리지와 시스템 간 전송 효율을 높이는 등 다양한 아이디어가 구체화되고 있다. 설계와 공정에서 진행 중인 기술 혁신에 힘입어 용량과 처리 속도는 하루가 다르게 개선되고 있으며, 연산 기능을 탑재해 메모리의 역할을 확대하려는 시도도 활발하다.
SK하이닉스는 이처럼 빠르게 변화하는 기술 흐름을 한발 앞서 읽고, 고객에게 최적의 설루션을 제공하기 위해 많이 고민해 왔다. 지난 15일부터 20일까지 미국 일리노이주 시카고에서 열린 ‘슈퍼 컴퓨팅 2026(Supercomputing 2026)’은 그 고민의 결과물을 확인할 수 있는 자리였다.
슈퍼 컴퓨팅 2026은 고성능 컴퓨팅(HPC)과 AI 분야의 최신 기술이 한자리에 모이는 글로벌 컨퍼런스다. 올해는 1만여 명이 전시장을 찾았고, 500여 개 기업과 기관이 전시에 참여했다. SK하이닉스는 전시 기간 데모 시연을 통해 차세대 설루션을 상세히 소개했고, 메모리를 중심으로 AI 생태계를 재편해 나가기 위한 기술 비전도 제시했다. 글로벌 고객 및 파트너사와는 협력 관계를 다지는 한편, 차세대 컴퓨팅 시장의 최신 기술 트렌드를 면밀히 살피며 새로운 사업 기회도 모색했다.
차세대 서버 랙 시스템 ‘MARS’ 시연… 한층 향상된 AI 성능 확인
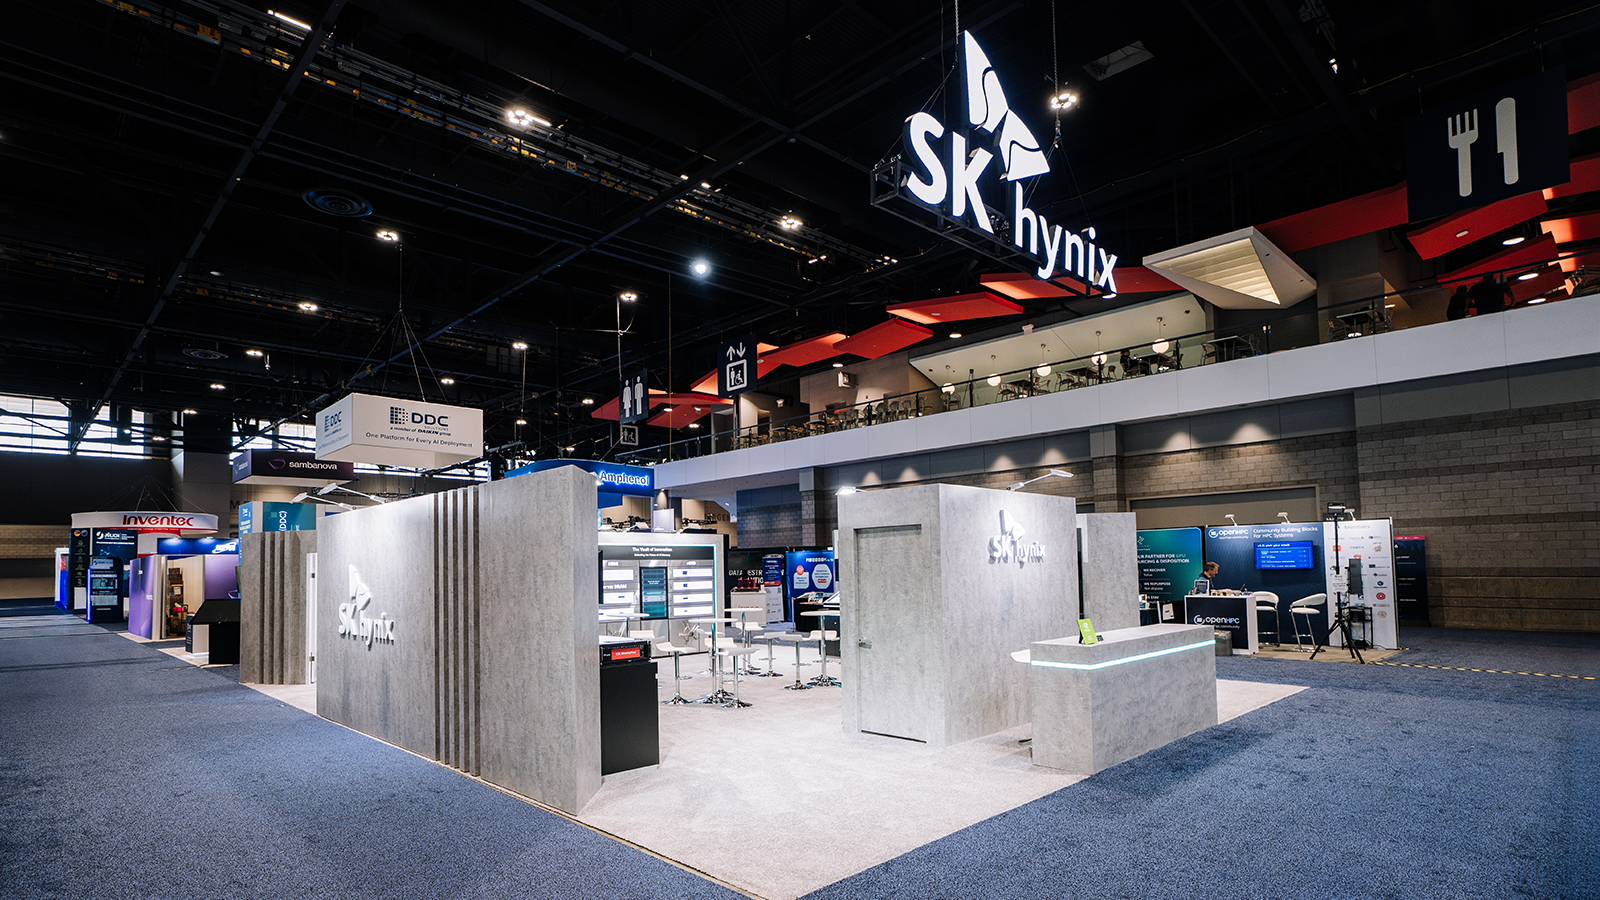
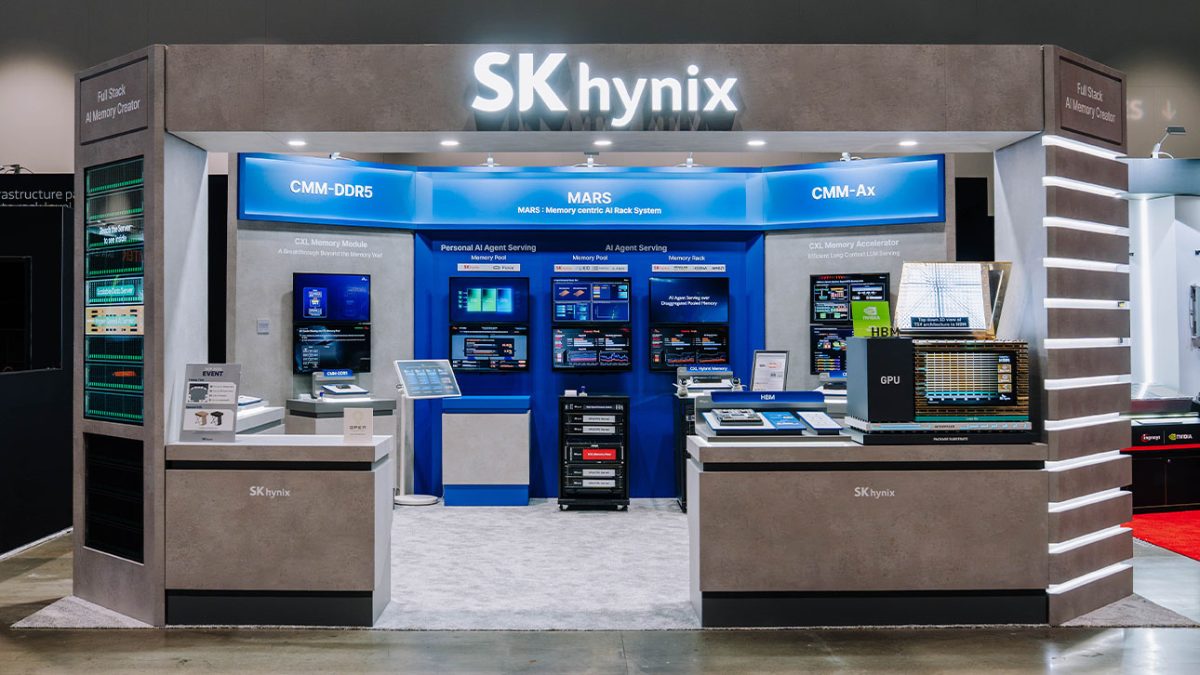
▲ SK하이닉스의 전시 부스
SK하이닉스는 거친 질감의 회색 벽면을 따라 푸른빛이 윤곽을 그려내는 감각적인 부스 디자인으로 차세대 메모리 기술의 이미지를 구현했다. 어두운 전시 공간에서도 또렷하게 살아난 부스의 존재감은 지나던 관람객의 시선을 사로잡았다.
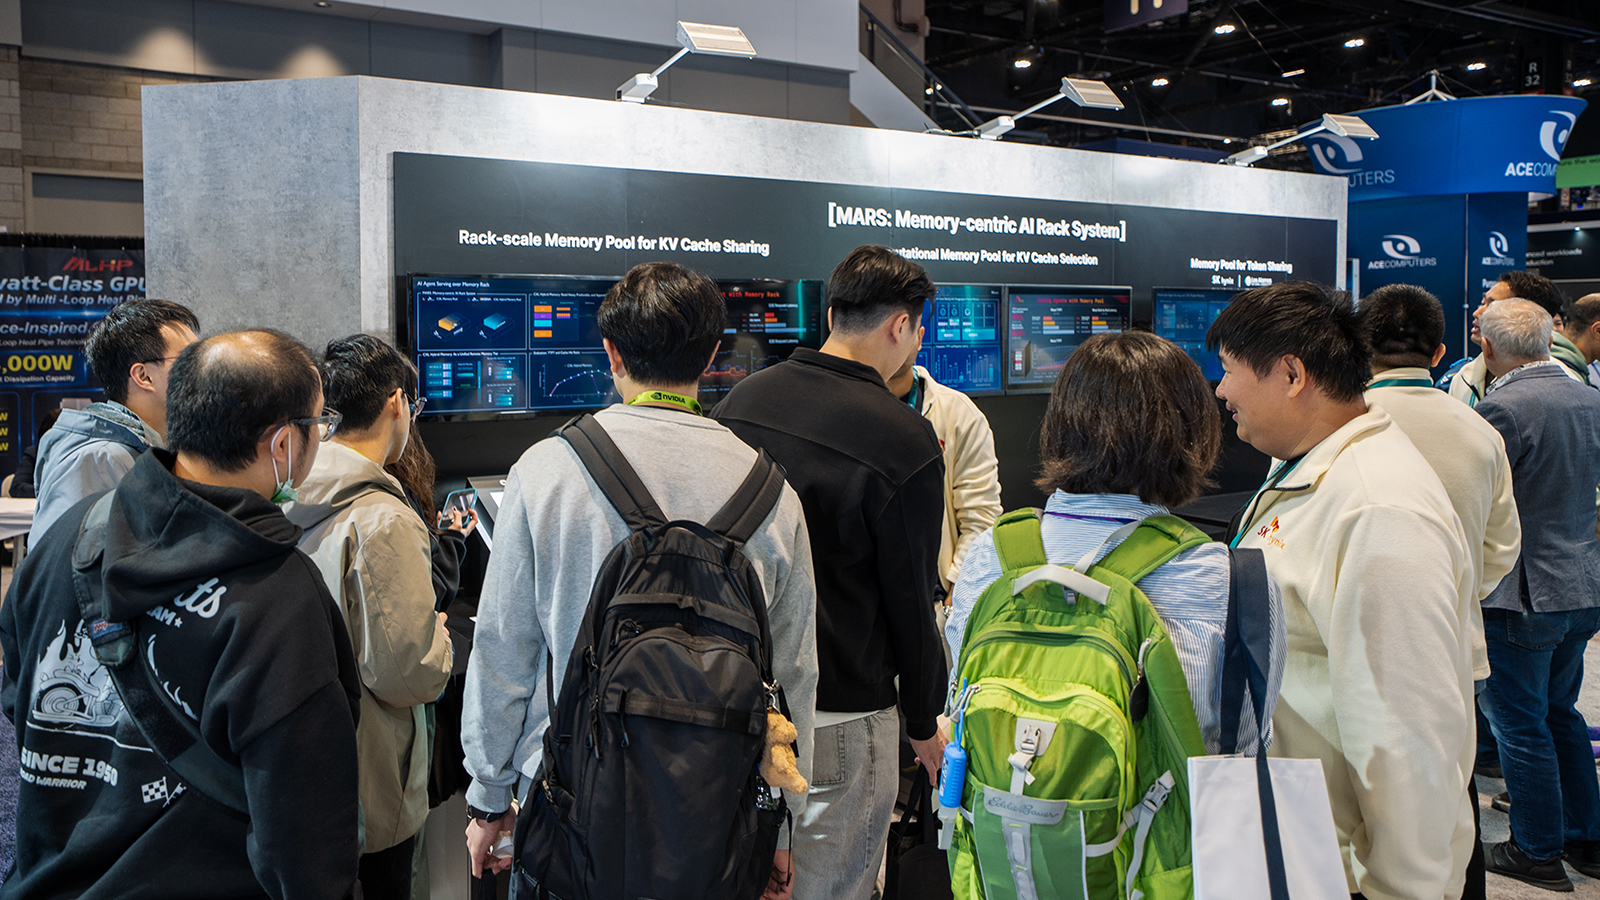
▲ MARS 섹션을 둘러보고 있는 관람객들
입구로 들어서 오른편 벽면으로 걸음을 옮기면 MARS 섹션이 먼저 눈에 들어온다. MARS(Memory-centric AI Rack System)는 메모리를 중심으로 파트너사의 설루션을 하나의 랙*에 통합해 효율을 극대화한 차세대 시스템이다. MARS 섹션에서는 이와 관련해 세 가지 데모를 시연했다.
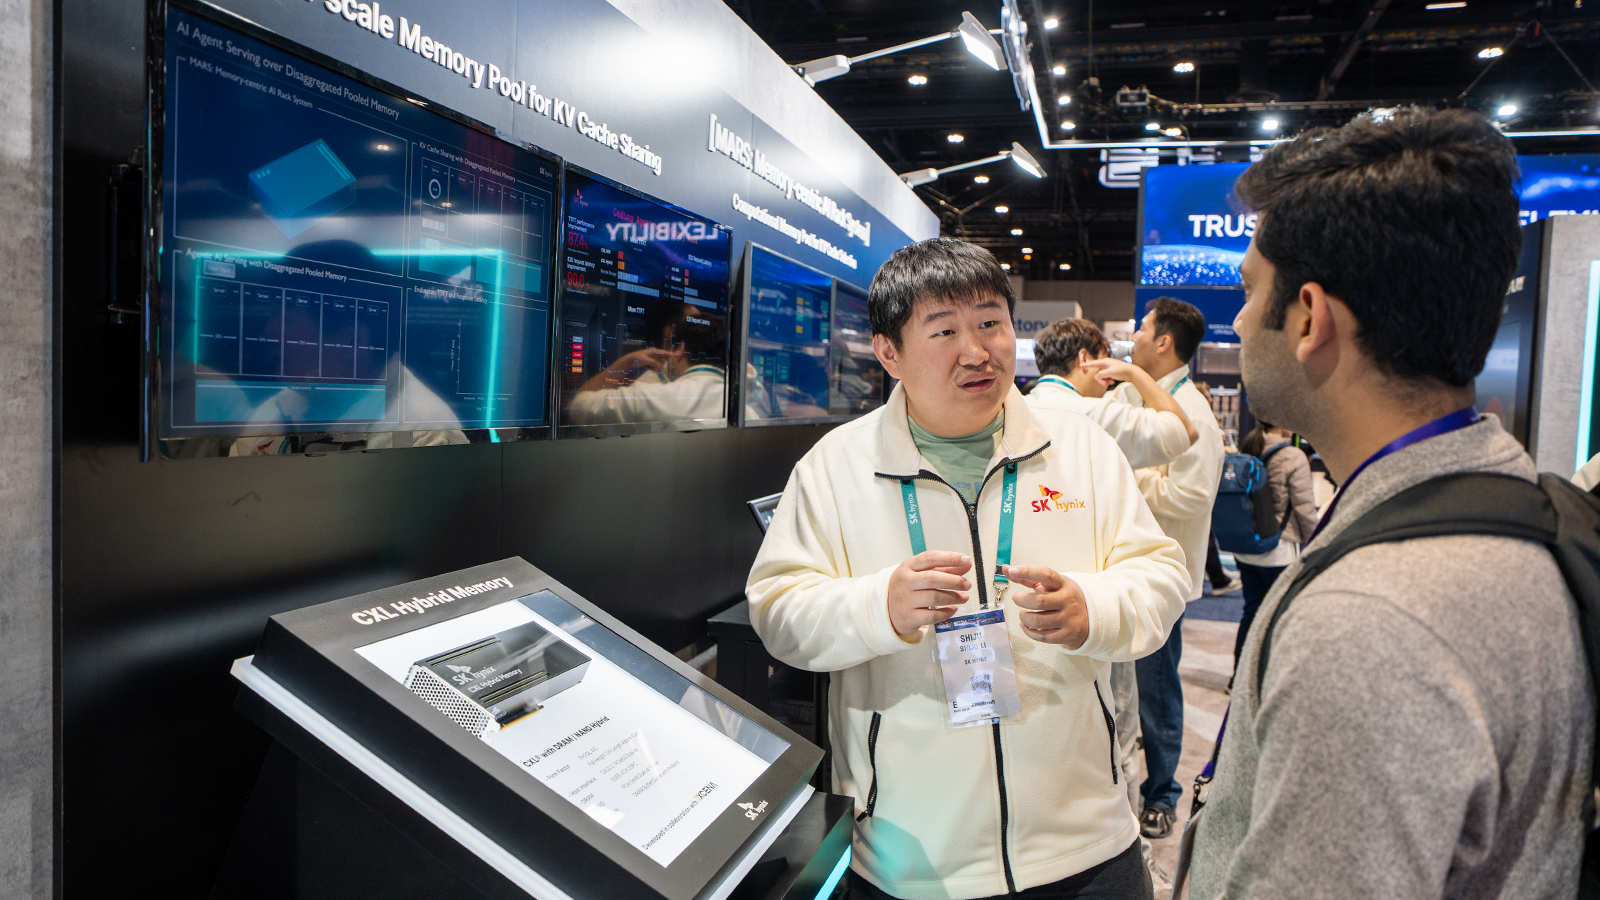
▲ 랙 단위로 KV 캐시를 공유하는 풀드 메모리 시연 모습
첫 번째 데모에서는 CXL* 메모리와 CXL 하이브리드 메모리*를 묶어, 랙 단위로 KV 캐시*를 공유하는 풀드 메모리*를 선보였다. 지속적으로 생성되는 대규모 KV 캐시는 CXL 하이브리드 메모리 내 SSD에 저장하고, 이를 재사용할 때는 기존 대화와 작업 이력을 기반으로 필요한 KV 캐시를 예측해 D램으로 빠르게 가져오는 방식이다. 이를 통해 AI 구동에 필요한 방대한 정보를 저장할 수 있는 대용량 스토리지를 확보하면서, 빠른 읽기 성능도 구현할 수 있음을 보여줬다.
* CXL 하이브리드 메모리(CXL Hybrid Memory): D램 기반의 CXL 메모리에서 더 나아가 D램과 SSD를 결합한 CXL 기반 메모리 설루션
* KV 캐시(Key Value Cache): 대규모 언어모델 기반 AI 에이전트가 텍스트를 생성할 때 이전에 계산한 결과를 저장해두는 임시 메모리. 사용자와 대화가 길어질수록, 처리할 작업이 많을수록 기하급수적으로 커져 이를 효율적으로 저장하고 처리하는 메모리 역량이 AI 에이전트의 성능에 큰 영향을 미침
* 풀드 메모리(Pooled Memory): 여러 개의 CXL 메모리를 묶어 풀(Pool)을 만들고 이를 여러 호스트가 용량을 나누어 사용함으로써 전반적인 메모리 사용률을 높이는 기술
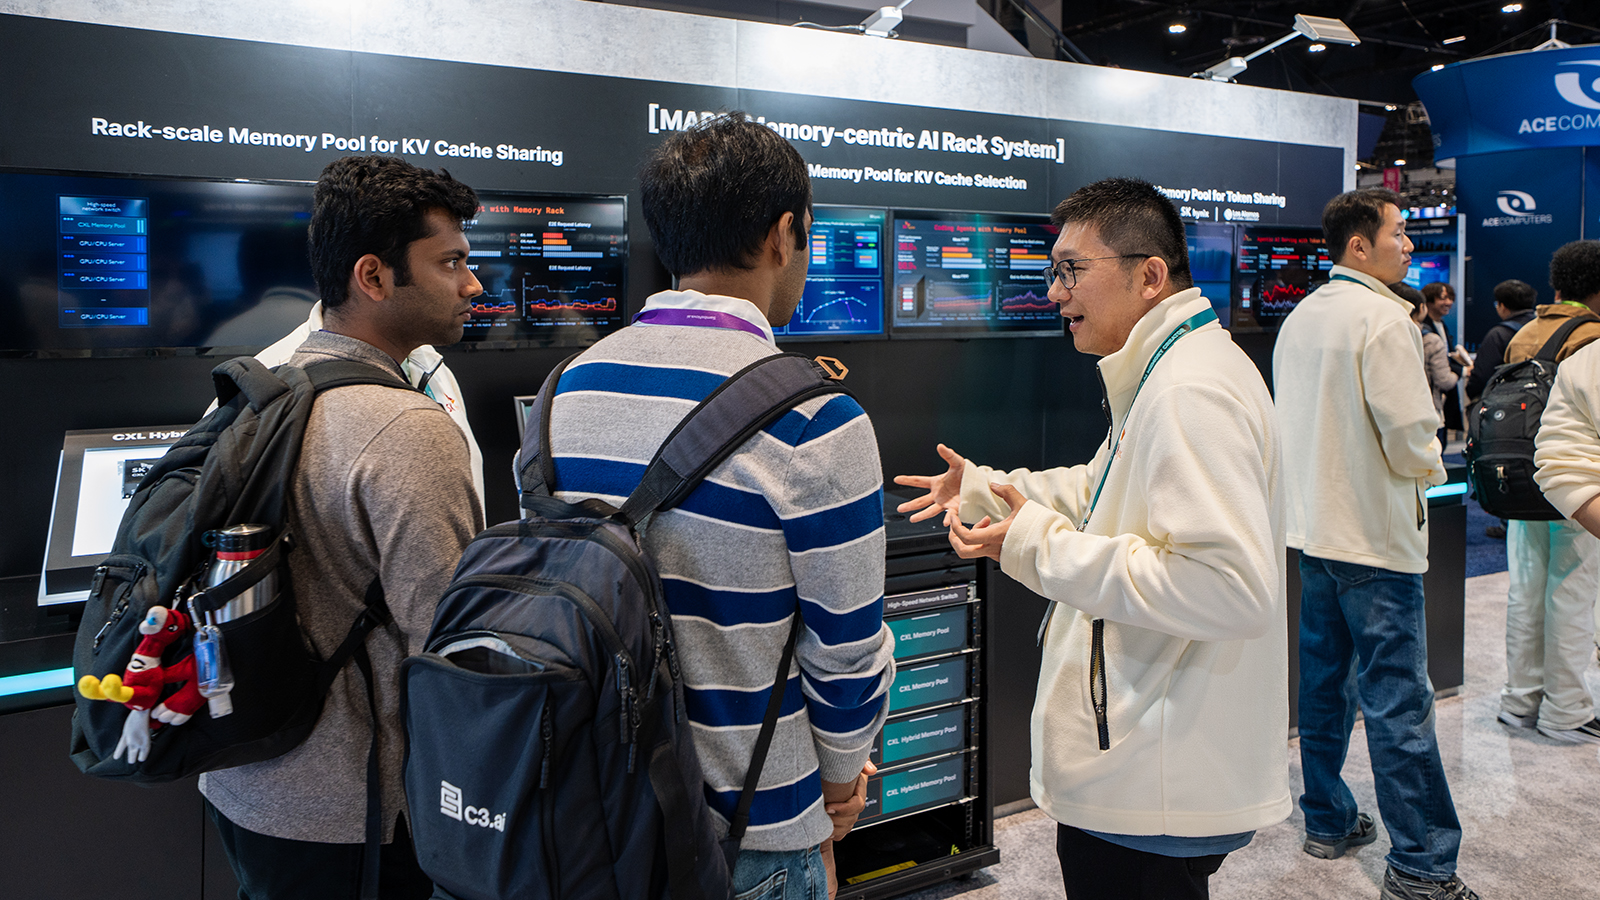
▲ 연산형 풀드 메모리를 활용한 AI 에이전트 서빙 기술 시연 모습
두 번째 데모에서는 연산형 풀드 메모리*로 여러 서버와 GPU를 연결해 효율성을 높인 AI 에이전트 서빙 시스템(AI Agent Serving System)을 시연했다. 이를 통해 CXL 기반 연산형 풀드 메모리를 활용해 KV 캐시를 선택적으로 전달하거나 재사용할 경우, 네트워크 통신을 이용하는 기존 방식보다 시스템 성능을 크게 높일 수 있음을 입증했다.
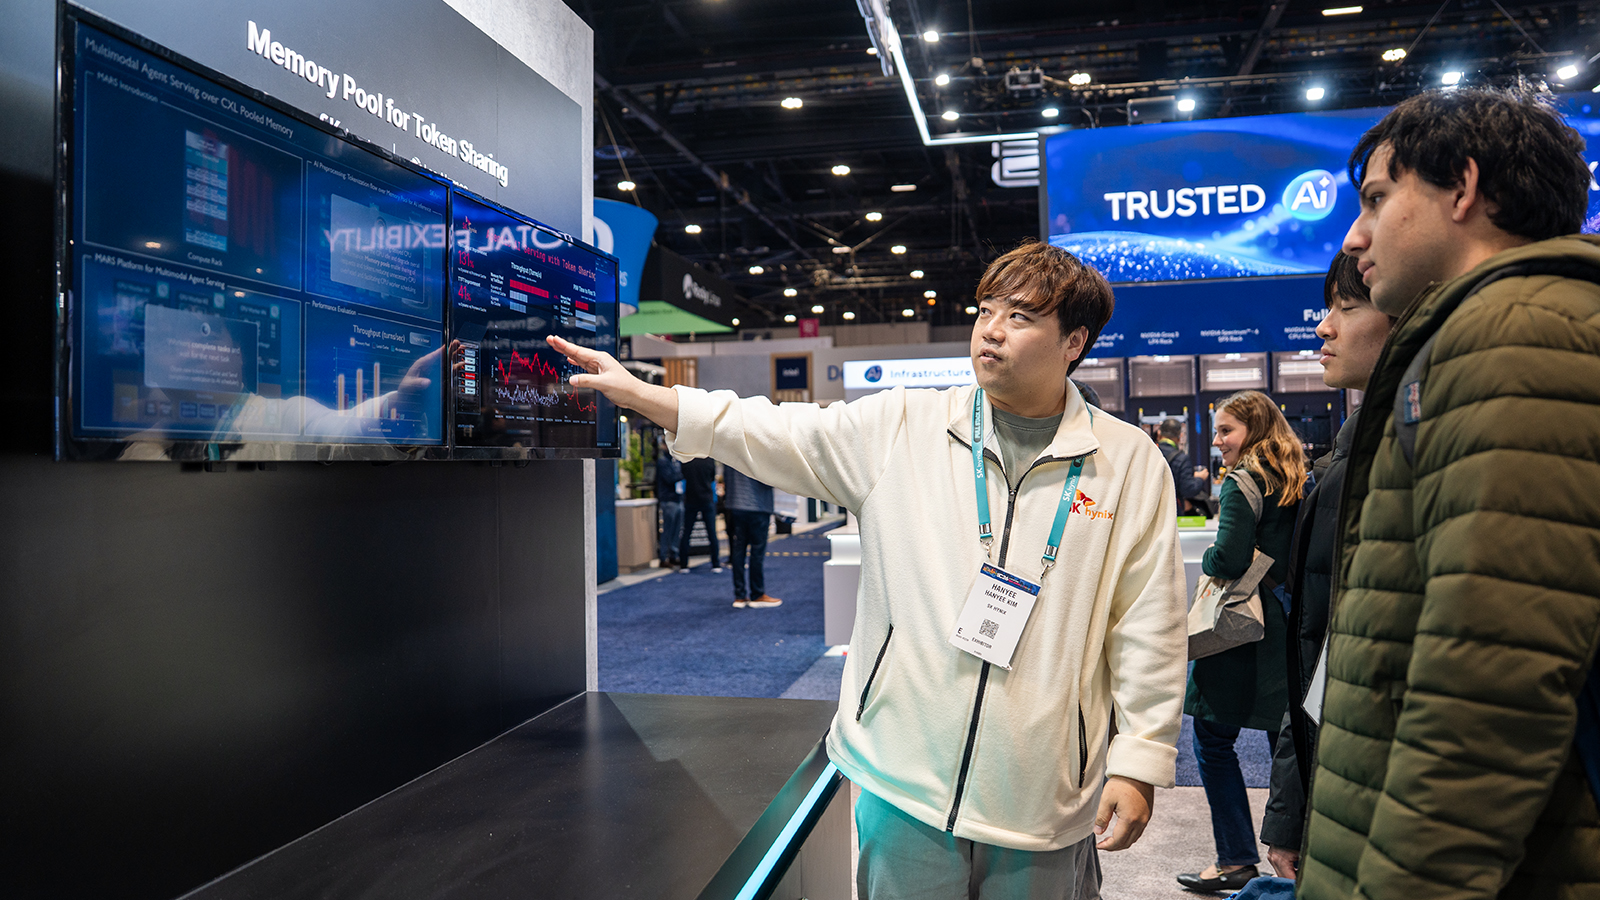
▲ CXL 풀드 메모리 기반 토큰 공유 기술 시연 모습
세 번째 데모에서는 CXL 풀드 메모리로 연결된 CPU 서버들이 생성한 토큰을 공유하는 방식으로 멀티모달* AI 서비스의 성능을 높이는 과정을 선보였다. 멀티모달 AI 서비스의 경우 토큰화* 시간이 성능에 큰 영향을 미치는데, CPU 전처리가 지연되면 GPU 대기가 늘어 처리 효율이 떨어지기 때문이다. SK하이닉스는 CXL 풀드 메모리로 CPU 서버 간 요청 데이터와 토큰을 공유해 중복 처리를 줄였고, 이를 통해 CPU 자원 활용과 작업 분배(Worker Scheduling)를 효율화하고 전처리를 개선했다. 그 결과 GPU 대기 시간은 단축됐고, 서빙 성능은 한층 향상됐다.
* 토큰화(Tokenization): AI 모델이 처리할 수 있도록 텍스트나 이미지 등의 데이터를 토큰이라는 최소 단위로 잘게 나누는 과정
저장 효율 높이고 연산 기능은 더하고… 메모리 기술 발전 방향 제시
반대편 벽면에는 시스템 데모 섹션이 자리했다. 왼쪽부터 KV Cache Offloading over CXL, Compute-using-DRAM, Custom HBM Array 등 세 가지 기술이 차례로 소개돼, 관람객들의 발길을 멈춰 세웠다.
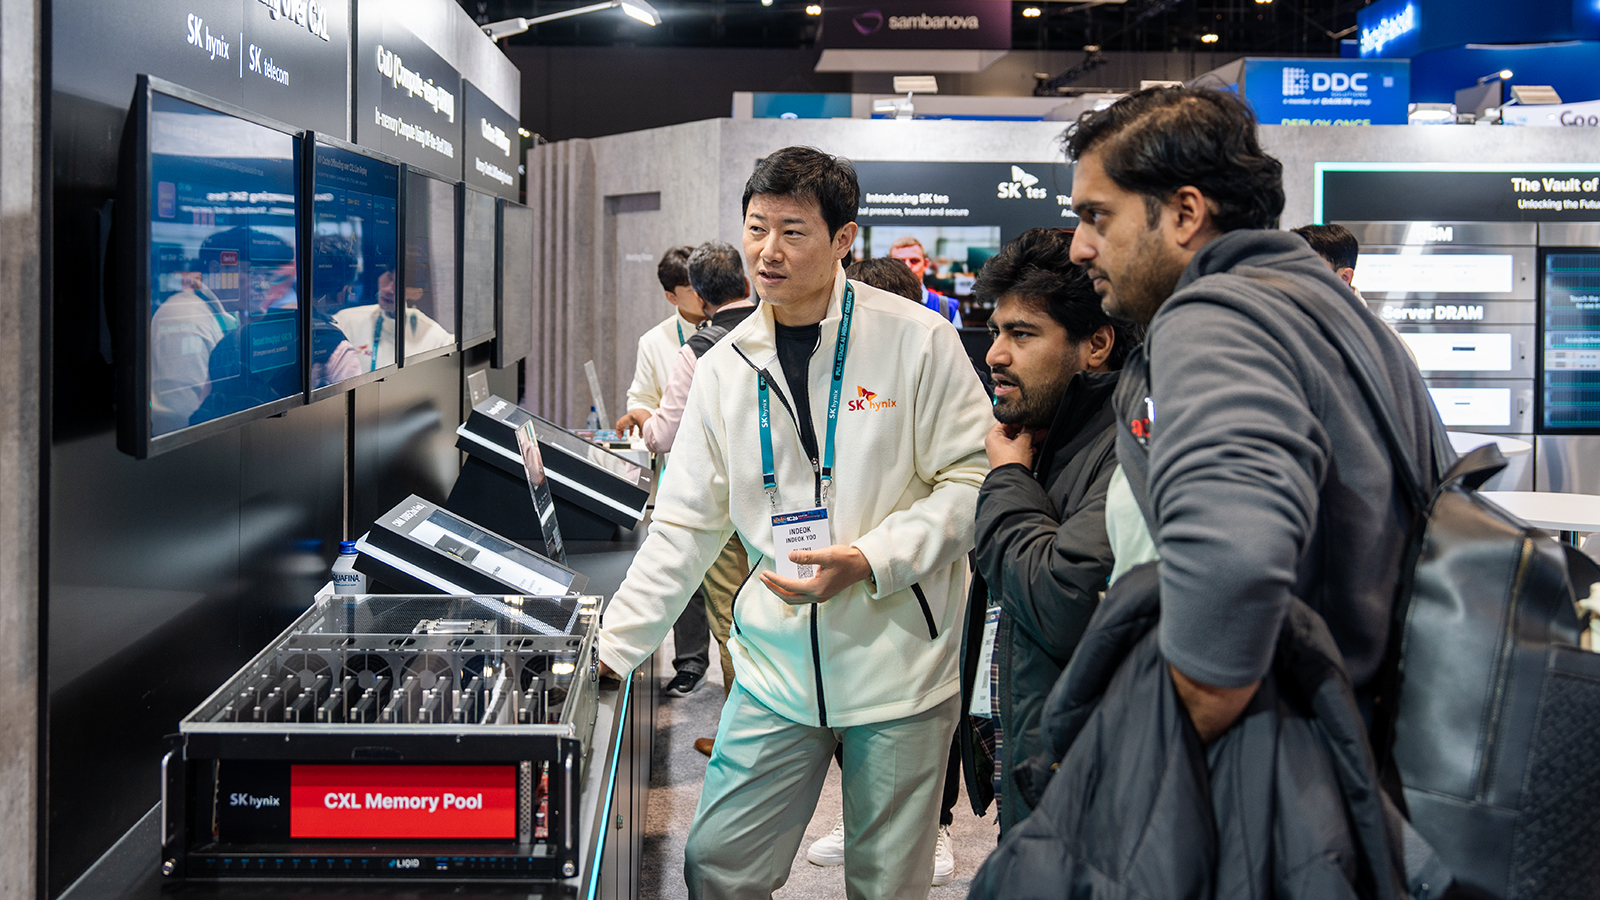
▲ KV Cache Offloading over CXL 존에서 데모 영상을 시청 중인 관람객들
KV Cache Offloading over CXL 존에는 기술 콘셉트 소개 영상과 데모 영상, 구성 제품 상세 소개 배너가 전시됐다. KV Cache Offloading over CXL은 AI 데이터센터에서 메모리를 수요에 맞춰 효율적으로 배치하고 공유할 수 있도록 지원하는 새로운 AI 메모리 기술이다. HBM*과 D램으로만 구성되던 AI 메모리 계층에 CXL 메모리 풀을 추가한 구조로, 곧 쓰일 KV 캐시는 HBM과 D램에 우선 배치되고 나중에 다시 불러낼 KV 캐시는 CXL 메모리 풀에 보관된다. 재사용 빈도와 최근 사용 시점, 크기와 복원 비용까지 따져 저장 위치를 정하기 때문에 단순한 용량 증설을 넘어서는 효과를 가져올 수 있으며, 메모리 풀을 활용해 수요 변화에 맞춰 자원을 다시 배분하거나 여러 호스트가 용량을 나눠 쓸 수도 있다. SK하이닉스는 AI 데이터센터 사업을 추진하는 SK텔레콤과 함께 실제 LLM* 추론 환경에서 실증을 마쳤고, 이번 전시에서는 이 같은 효율 향상 효과를 데모 영상으로 한눈에 확인할 수 있도록 했다.
* LLM(Large Language Model): 빅데이터를 학습해 사람의 언어를 이해하고 자연스러운 문장을 생성하는 인공지능 모델
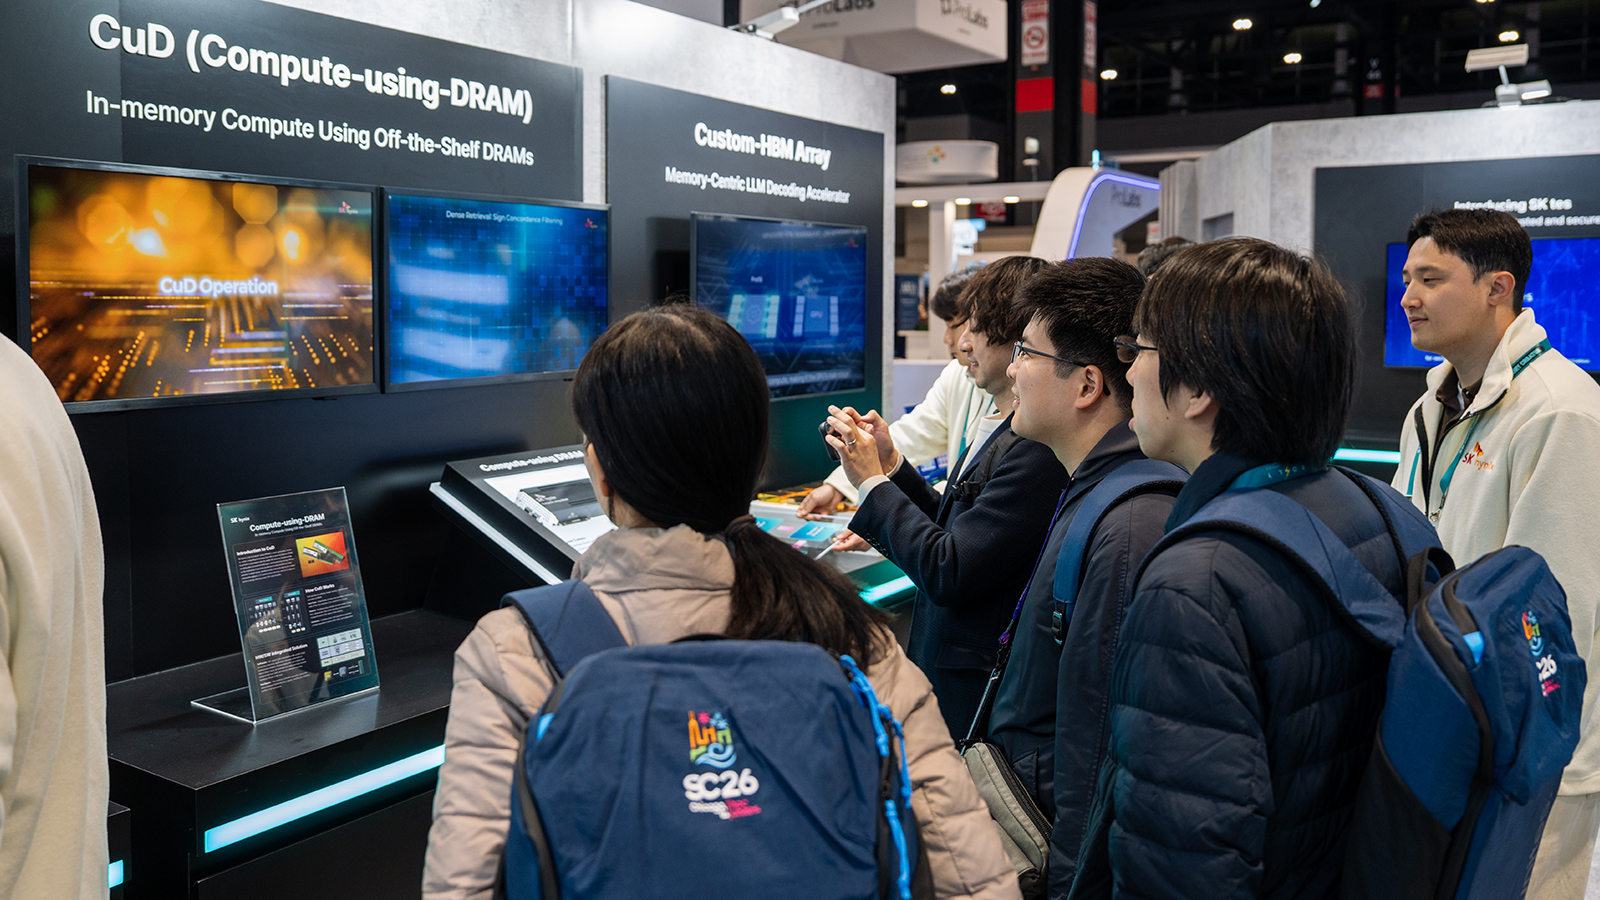
▲ Compute-using-DRAM 설루션 소개 브로슈어를 살펴보고 있는 관람객들
Compute-using-DRAM 존은 기술 콘셉트 소개 영상과 데모 영상, 그 아래 배치된 제품 및 설루션 소개 브로슈어로 구성됐다. Compute-using-DRAM은 D램 셀 배열이 본래 지닌 전하 공유* 동작을 활용해 메모리 내부에서 연산을 수행하는 기술이다. 수천에서 수만 비트에 이르는 행(Row)을 한 번에 활성화하는 D램의 구조를 이용해, 행간 데이터 복사와 여러 행의 동시 활성화로 비트 단위 연산을 병렬 처리한다. 별도의 연산 유닛 추가 없이 상용 D램을 그대로 쓰기 때문에 칩 면적과 용량 손실을 최소화하면서도 대역폭과 전력 효율을 함께 높일 수 있다. 특히 AI 연산에서 발생하는 대용량의 데이터를 연산 유닛의 캐시 계층으로 가져가지 않고, 메모리 내부에서 로직 연산과 이를 활용한 사칙 연산, 대규모 데이터 비교 등의 간단한 연산을 직접 수행한 뒤 결괏값만 전송할 수 있어, AI 시스템의 데이터 전송 효율을 끌어올릴 차세대 설루션으로 큰 주목을 받았다.
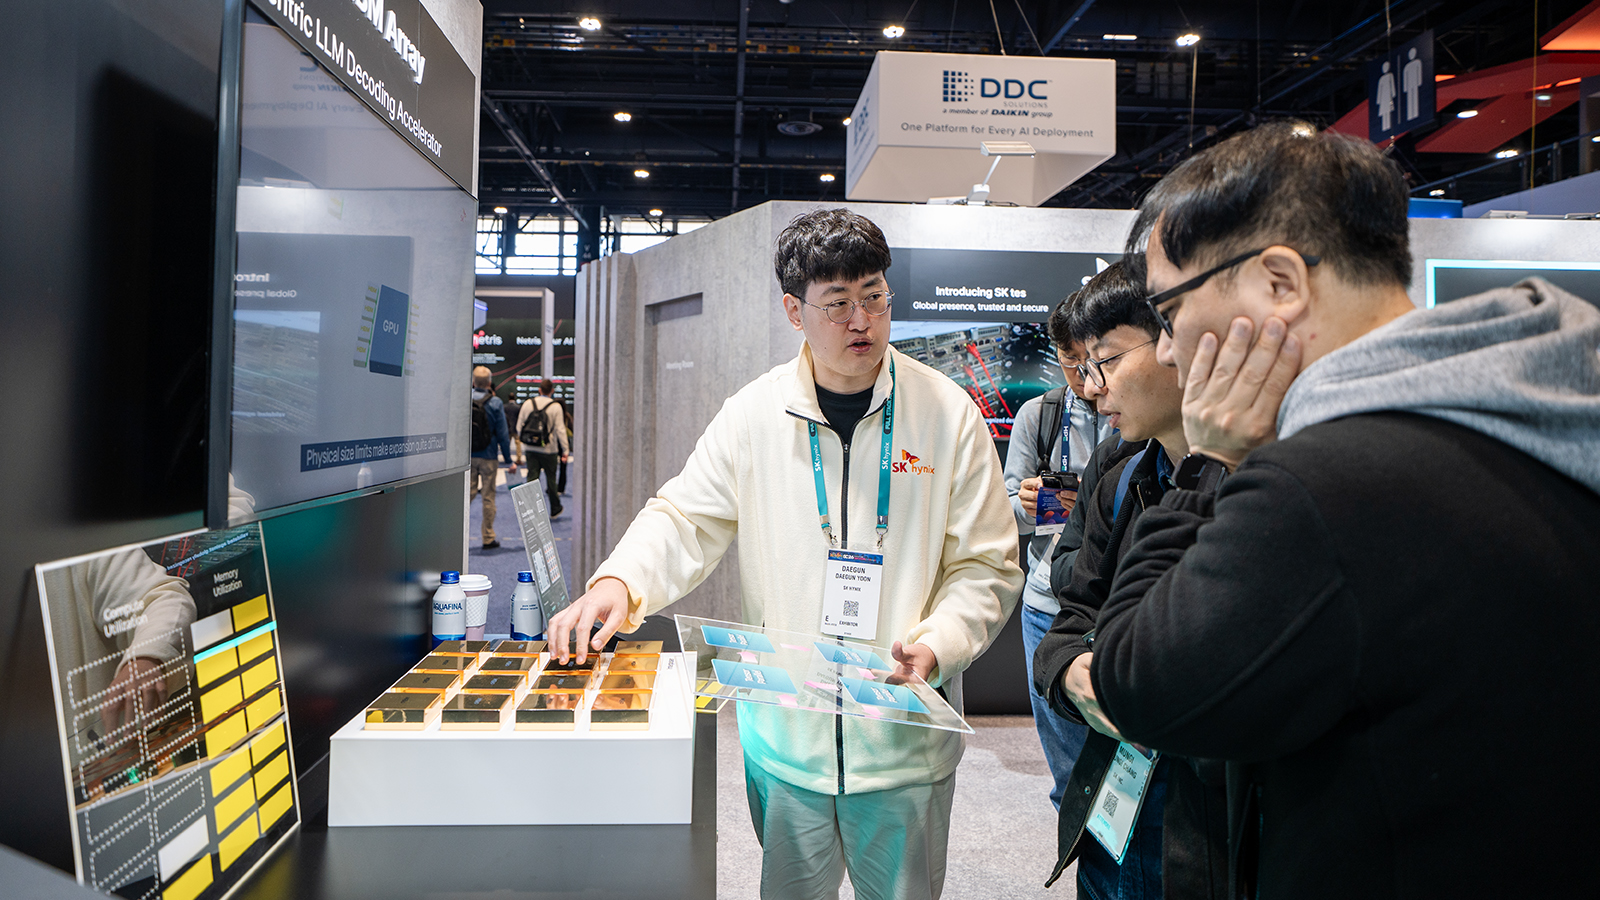
▲ Custom HBM Array 구조 모형을 들여다보고 있는 관람객들
Custom HBM Array 존에는 기술 콘셉트 소개 영상과 함께 제품 모형과 설루션 소개 브로슈어가 배치됐다. 기존 GPU 기반 시스템은 연결 가능한 HBM 개수가 정해져 있어 대역폭을 넓히는 데 한계가 있었고, LLM 디코딩(답변 생성) 수행 시 GPU 자원이 낭비되는 문제도 있다. Custom HBM Array는 연산 기능을 갖춘 cHBM* 여러 개를 연결하는 구조로 이러한 한계를 넘어섰다. 기존 GPU 기반 시스템보다 빠른 응답 속도와 높은 에너지 효율을 제공할 수 있으며, 데이터 이동의 병목 현상도 완화할 수 있을 것으로 기대된다. 이에 관람객들은 제품 모형 앞에서 내부 구조를 하나하나 살펴보며 관심을 내비쳤고, 주변의 스태프에게 궁금한 점을 물어보기도 하며 오랜 시간 머물렀다.
HBM부터 eSSD까지… AI 인프라를 떠받치는 SK하이닉스의 메모리 기술
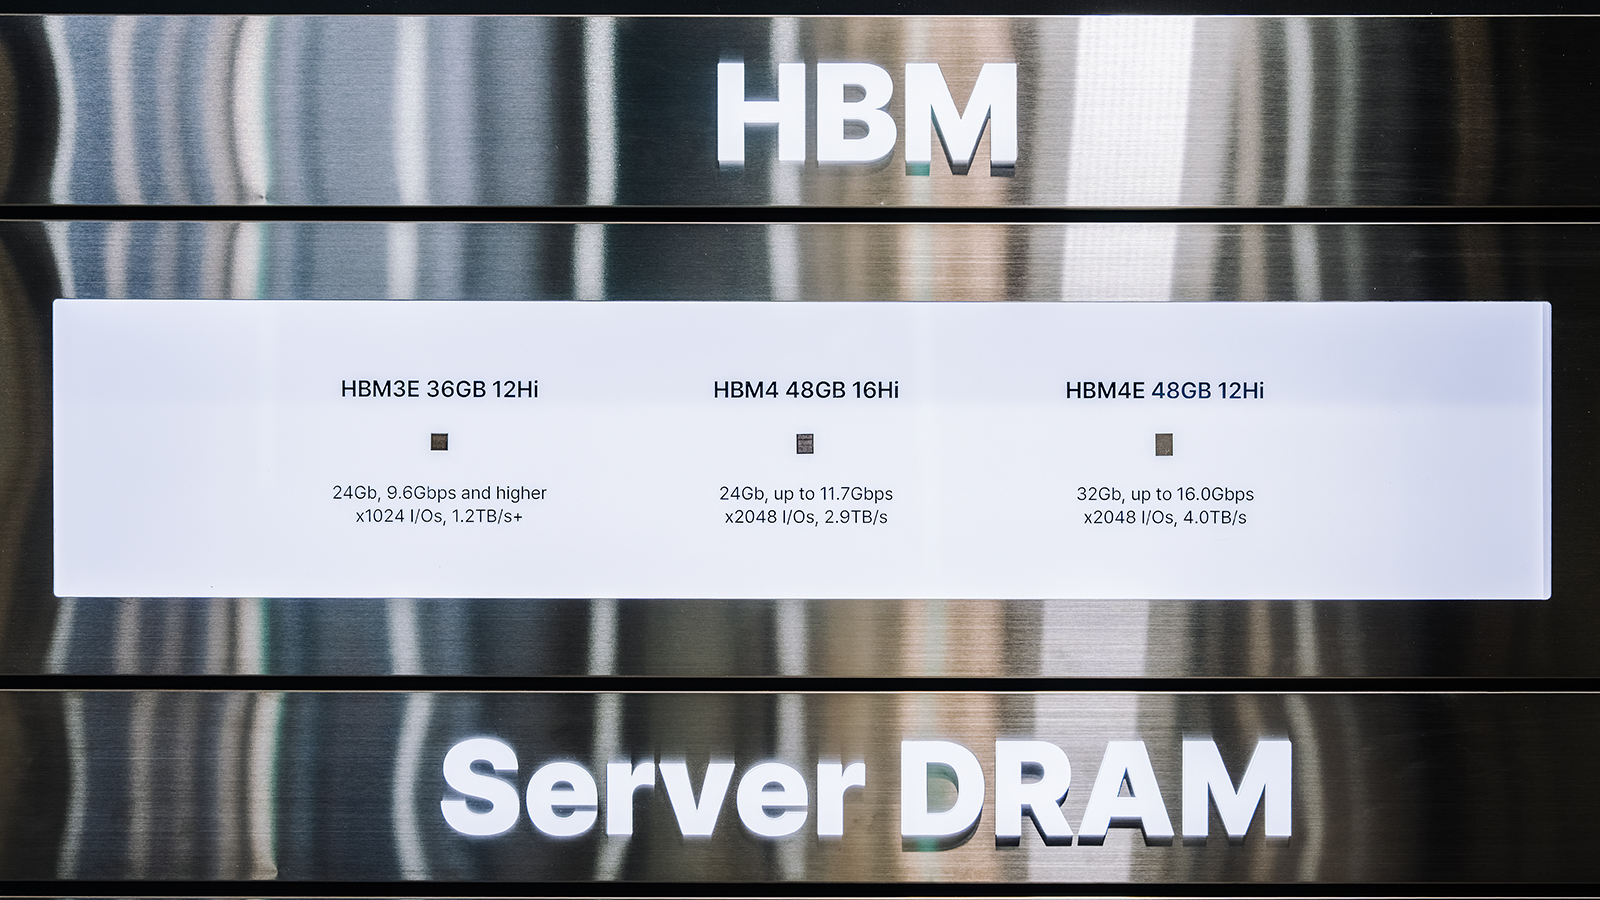
▲ SK하이닉스의 주요 HBM 제품
부스 뒤편 제품 포트폴리오 섹션에서는 AI 인프라를 구성하는 SK하이닉스의 핵심 제품 라인업이 소개됐다. 먼저 HBM 존에는 차세대 제품인 HBM4E, HBM4와 함께 현재 HBM 시장을 이끌고 있는 HBM3E가 나란히 전시됐다.
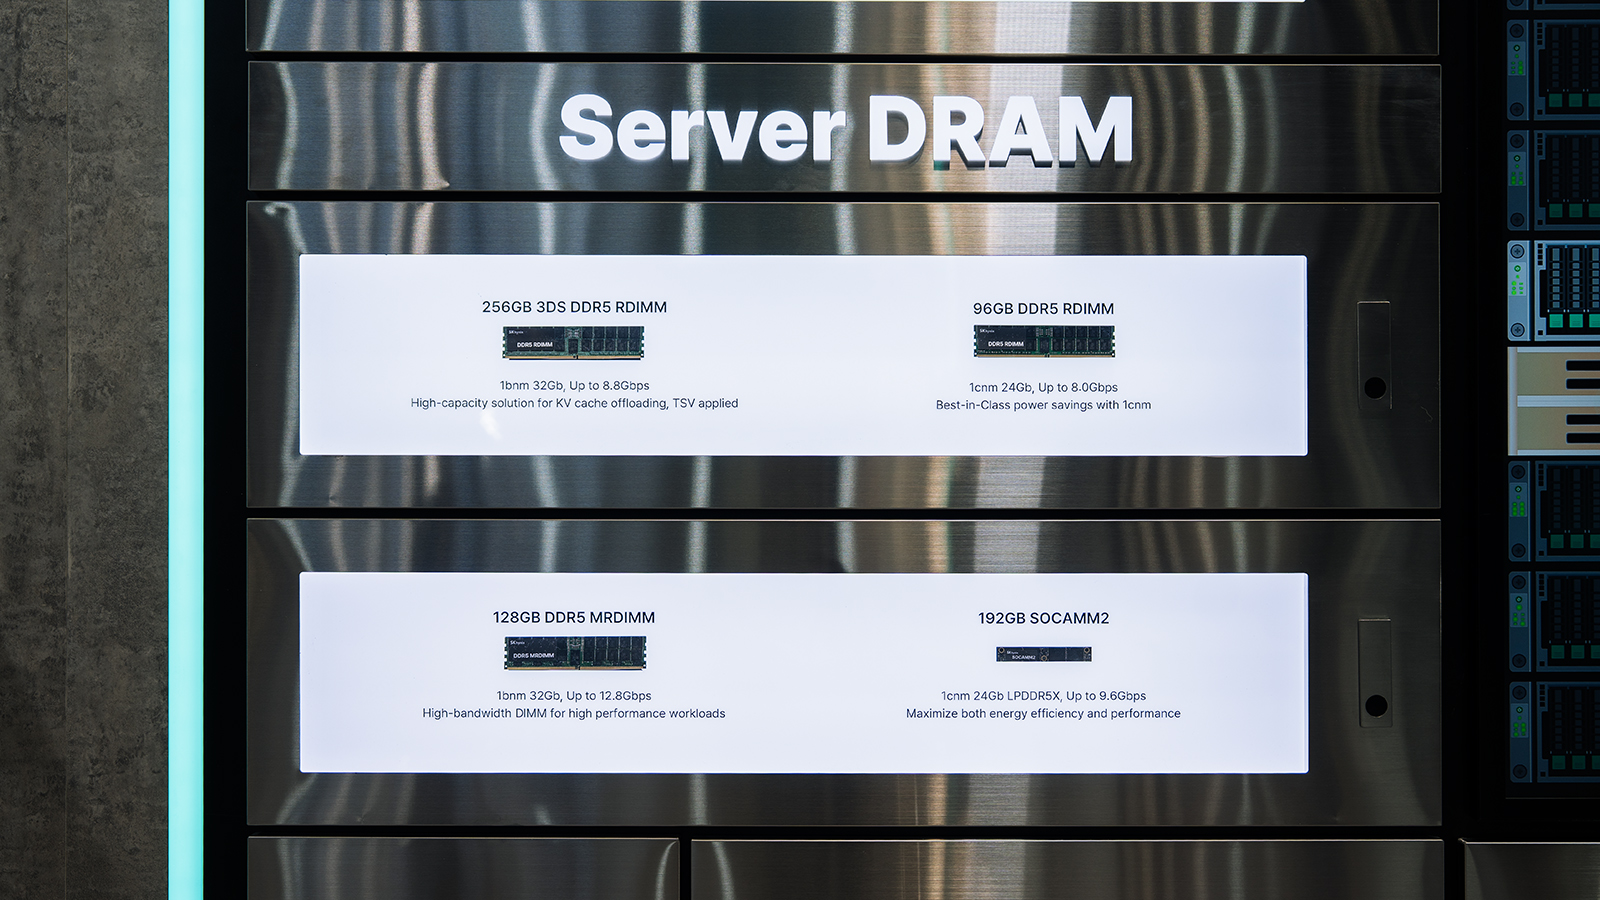
서버 D램 존에서는 AI 워크로드에 맞춰 업계 최대 용량을 구현한 ‘256GB 3DS* DDR5 RDIMM*’을 비롯해 고대역폭을 갖춘 ‘128GB DDR5 MRDIMM*’, 범용성이 높은 ‘96GB DDR5 RDIMM’을 선보였다. 이에 더해 새로운 폼팩터로 전력 효율과 공간 효율을 함께 높인 ‘192GB SOCAMM*2’도 함께 놓였다.
* RDIMM(Registered Dual In-line Memory Module): 서버와 워크스테이션에 쓰이는 D램 모듈로, 신호를 중계하는 레지스터를 두어 안정성을 높인 제품
* MRDIMM(Multiplexed Rank Dual In-line Memory Module): 두 개의 랭크를 동시에 활용해 대역폭을 끌어올린 서버용 D램 모듈
* SOCAMM(Small Outline Compression Attached Memory Module): 저전력 D램을 기반으로 한 서버용 모듈 규격으로, 전력 효율과 공간 효율이 높은 것이 특징
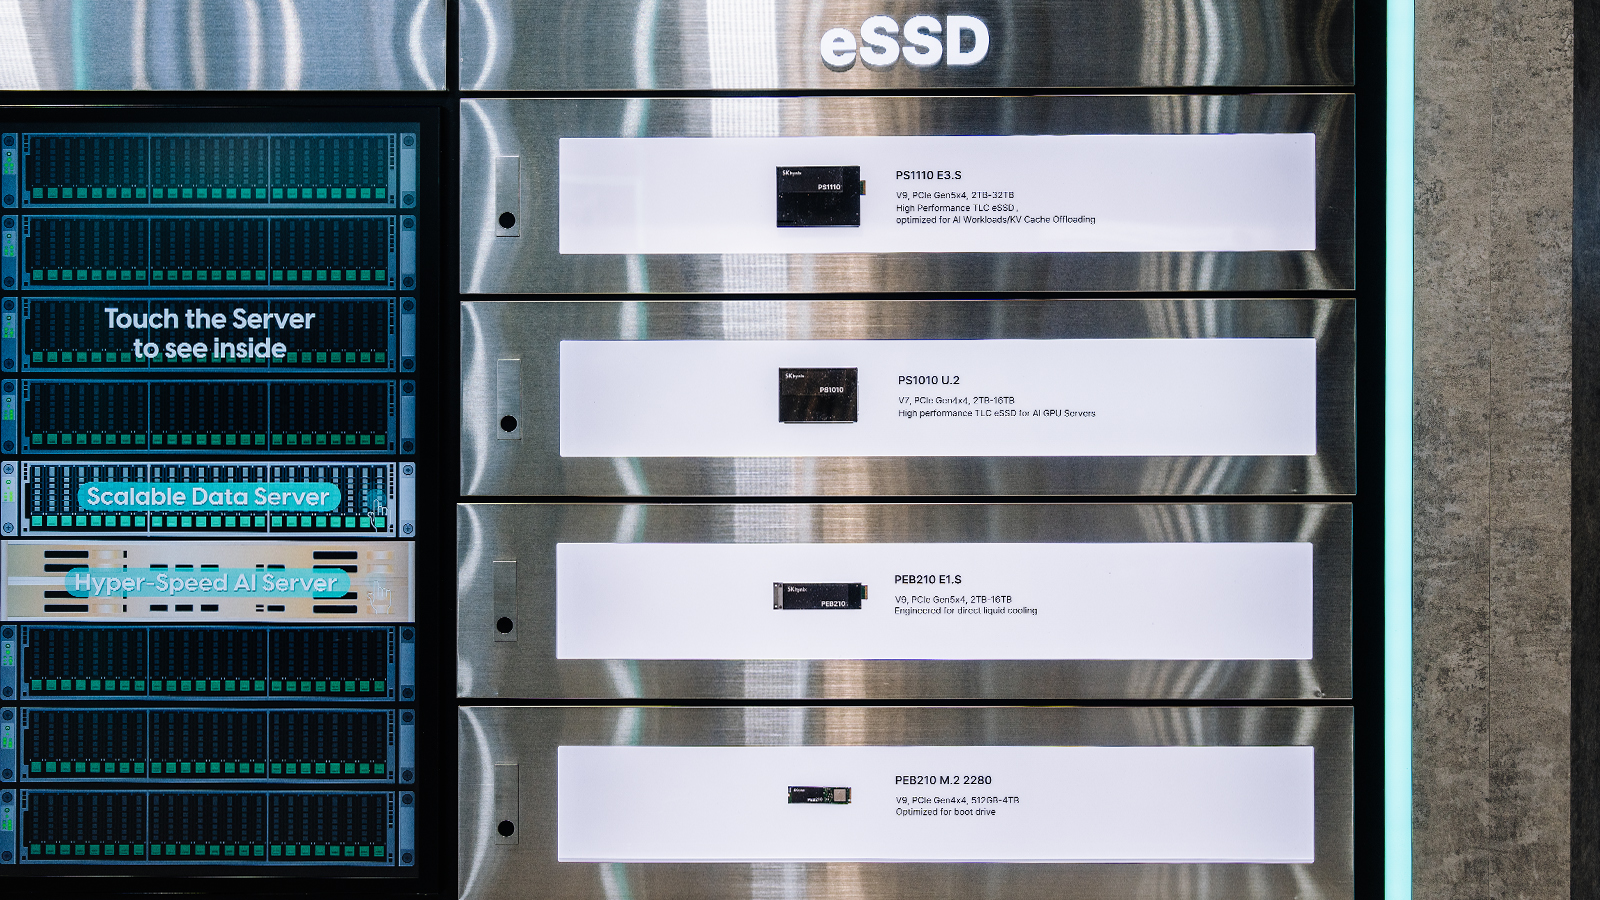
eSSD 존에서는 액체냉각(Direct Liquid Cooling, DLC)을 지원하는 ‘PEB210 E1.S’와 NVMe* E3.S 규격에 맞춰 고용량과 저전력을 구현한 ‘PS1110 E3.S’가 가장 먼저 시선을 끌었다. 여기에 더해 ‘PS1010 U.2’, ‘PEB210 M.2 2280’ 등 각기 다른 활용도로 고객의 다양한 요구를 충족시켜 줄 최신 eSSD 제품들로 라인업을 채웠다.
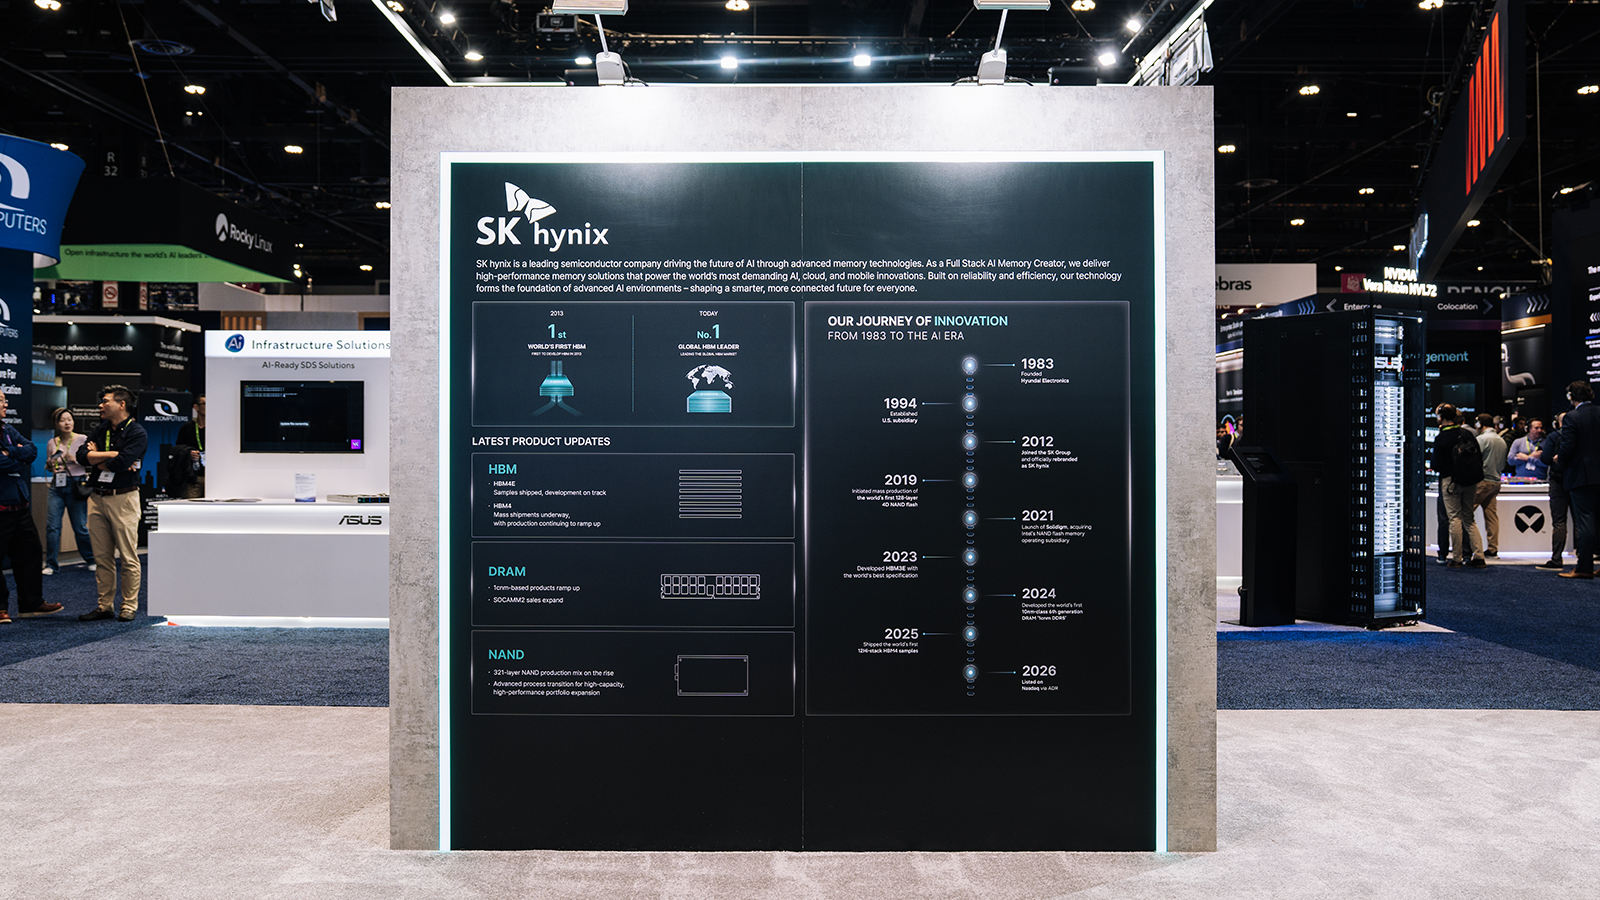
▲ SK하이닉스의 연혁과 비전, HBM 개발 여정과 최신 제품 현황이 소개된 회사 소개 섹션
부스 입구 벽면 뒤편에는 회사 소개 섹션이 자리했다. 벽면 그래픽을 따라 SK하이닉스의 연혁과 비전이 펼쳐졌고, HBM 개발 여정과 함께 HBM, D램, 낸드 각 분야의 최신 제품 현황이 한눈에 담겼다.
“MARS, 에이전틱 AI 시대 이끌 기반 기술”
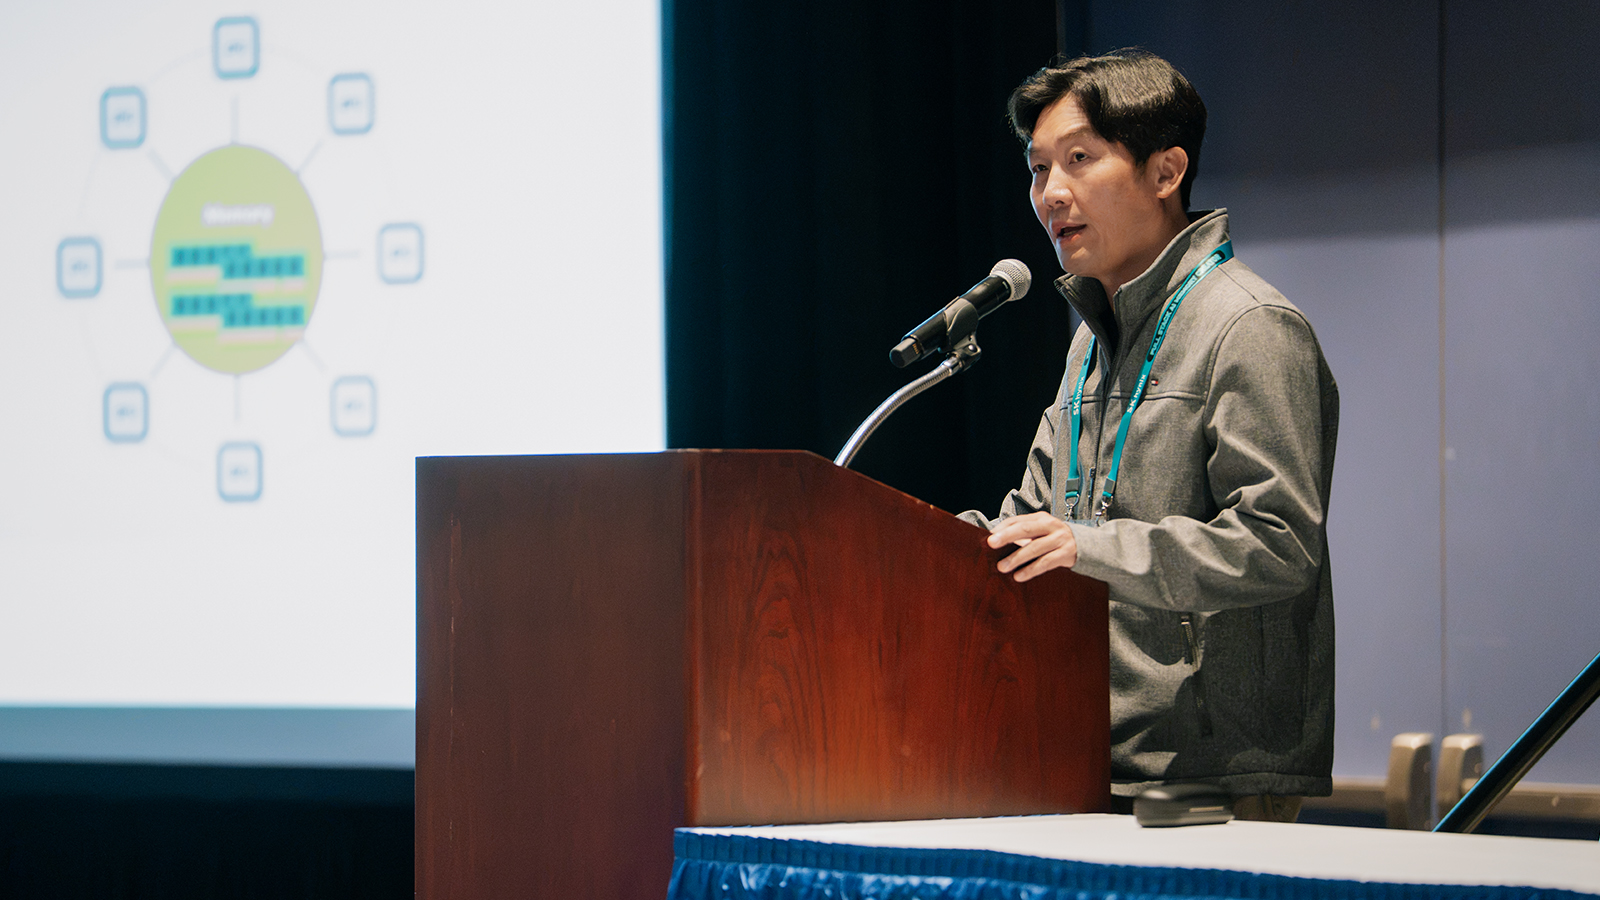
▲ 발표 중인 민영훈 TL(AI System Infra)
발표 세션에서는 민영훈 TL(AI System Infra)이 ‘공유 메모리 풀로 구현한 에이전틱 AI 서빙(Enabling Agentic AI Serving with Disaggregated Memory Pools)’을 주제로 연단에 올라, 메모리 중심 AI 시스템 아키텍처 MARS를 상세히 소개했다.
특히, MARS 아키텍처의 중심이 되는 CXL 메모리 풀 기반 KV 캐시 공유 · 재사용 및 CPU 랙의 토큰 공유(Token Sharing) 기술을 선보였다. 이를 통해 기존 방식 대비 GPU/CPU 활용률을 높여서 멀티 턴 기반의 Agentic AI 서빙 성능을 크게 개선할 수 있음을 설명했다.
SK하이닉스 관계자는 “메모리가 AI 인프라의 성능과 효율을 좌우하는 요소로 떠오르는 가운데, 이번 전시를 통해 회사의 기술 경쟁력과 AI 메모리 비전을 선명하게 전할 수 있었다”며 “앞으로도 AI 컴퓨팅 성능을 높여 갈 핵심 기술 파트너로서 고객과 함께 성장해 나가겠다”고 말했다.