[AI Ecosystem]은 AI를 하나의 모델이나 알고리즘이 아니라, 소프트웨어, 데이터센터 인프라, 반도체와 메모리 기술이 맞물려 작동하는 하나의 생태계로 바라보는 시리즈다.
AI 워크로드가 추론과 에이전틱 AI 중심으로 고도화될수록, 성능 경쟁의 기준도 달라지고 있다. 이제는 연산 능력뿐 아니라, 데이터를 어디에 저장하고, 얼마나 빠르게 이동시키며, 얼마나 효율적으로 처리할 것인가가 AI 시스템의 성능과 비용을 좌우한다.
이번 시리즈는 이러한 AI 생태계의 변화를 따라가며, 메모리 반도체가 왜 AI 시대의 핵심 기반으로 부상하고 있는지를 살펴보고, SK하이닉스가 함께 만들어갈 AI 메모리 생태계의 방향성을 조망한다.
4편에서는 애플, AMD, 인텔을 거치며 GPU·AI 가속기 아키텍처 분야를 이끌어 온 라자 쿠드리(Raja Koduri) OXMIQ Labs CEO와 함께, AI 반도체 설계의 무게중심이 왜 메모리로 이동하고 있는지 살펴본다.
① AI 연산의 패러다임 시프트
② 병목의 실체, 연산이 아닌 데이터
③ 인프라 재설계, 구조가 성능을 결정한다
④ 반도체 패러다임의 이동, 메모리 중심으로 – OXMIQ Labs CEO(창업자) Raja Koduri
⑤ AI의 완성, 피지컬 AI와 메모리 중심 설계
데이터 공급 병목의 시대
AI 인프라의 성능을 좌우하는 기준이 개별 연산 장치의 성능에서 시스템 전체의 데이터 흐름으로 옮겨가고 있다. GPU, 메모리, 네트워크, 스토리지가 어떻게 맞물리느냐가 성능과 효율을 가른다. 이 흐름은 반도체 설계의 질문도 바꿔놓았다. 데이터를 더 빠르게 공급하고 불필요한 왕복을 줄이려면, 칩과 패키지, 메모리 구조 자체부터 달라져야 한다.
칩 설계의 무게중심은 메모리로 옮겨가고 있다. 이는 일시적인 기술 트렌드가 아니다. 물리적 한계에서 비롯된 구조적 전환에 가깝다. 반도체 산업은 무어의 법칙*에 따라 더 많은 연산 회로를 하나의 다이에 집적해 왔고, 오늘날 AI 가속기는 페타플롭스*급 성능에 도달했다. 하지만 연산 장치에 데이터를 공급하는 대역폭은 그 속도를 따라가지 못했다.
* 페타플롭스(Petaflops): 초당 1,000조 회, 즉 10¹⁵회 수준의 부동소수점 연산 성능을 뜻하는 단위. AI 가속기나 슈퍼컴퓨터의 연산 성능을 설명할 때 쓰인다.
연산 자체의 비용은 낮아졌다. 곱셈과 덧셈 연산에는 몇 펨토줄(fJ)* 수준의 에너지만 필요하다. 반면 데이터를 온칩 S램*에서 읽어오는 데는 그보다 훨씬 많은 에너지가 들고, 오프칩 D램*에서 가져올 경우 비용은 수백 배에서 수천 배까지 커질 수 있다. 데이터가 연산 장치에서 멀어질수록 시간과 에너지 부담도 커진다.
칩 안에 집적할 수 있는 연산 유닛이 크게 늘면서, 성능의 병목은 점차 데이터 공급 쪽으로 이동하고 있다. 연산 장치가 멈추지 않고 일하려면 필요한 데이터를 제때 받아야 한다. 아무리 많은 연산 회로를 집적해도 데이터가 늦게 도착하면 그 성능은 온전히 쓰이지 못한다.
* 온칩 S램/오프칩 D램: 온칩 S램은 연산 장치와 같은 칩 안에 있는 고속 메모리이고, 오프칩 D램은 칩 외부에 위치한 메모리다. 일반적으로 연산 장치에서 멀리 떨어질수록 데이터 접근 지연과 에너지 비용이 커진다.
메모리 용량에서도 같은 문제가 나타난다. 레지스터부터 공유 캐시까지 이어지는 온칩 메모리 계층은 빠르지만, 담을 수 있는 데이터의 양은 제한돼 있다. 반면 최신 AI 모델은 훨씬 더 큰 파라미터와 중간 데이터를 다룬다. 결국 데이터는 HBM이나 DDR에서 들어왔다가 사용 후 밀려나고, 필요할 때 다시 불려 온다. 이 반복적인 스트리밍이 시스템의 시간과 에너지 부담을 키운다.
따라서 AI 반도체의 성능 경쟁은 연산 속도를 높이는 데서, 확보한 연산 능력을 계속 가동할 수 있도록 데이터를 안정적으로 공급하는 방향으로 옮겨가고 있다. 대규모 학습과 큰 배치 추론에서는 연산 자원이 병목처럼 보일 수 있지만, 저지연·소규모 배치 추론에서는 메모리 대역폭이 성능을 제한한다. 같은 실리콘이라도 워크로드에 따라 병목의 위치가 달라진다. 이 때문에 메모리는 AI 아키텍처의 출발점으로 올라섰다.
트랜스포머와 메모리 계층의 변화
이 부담을 줄이기 위해 컴퓨터 아키텍처는 오래전부터 캐시를 써 왔다. 캐시는 데이터 재사용을 전제로 한 기술이다. 한 번 데이터를 가까운 곳으로 가져오면, 이를 여러 차례 활용함으로써 데이터를 처음부터 불러오는 비용을 나눠 쓸 수 있다. 기존 컴퓨팅 워크로드에서는 이 가정이 상당히 잘 맞았다. 비교적 작은 온칩 S램만으로도 D램 접근을 크게 줄일 수 있었고, 이는 오랫동안 컴퓨터 아키텍처에서 가장 효과적인 성능 개선 방식 중 하나였다.
하지만 오늘날 AI 모델의 주류인 트랜스포머*는 이 전제를 흔들었다. 방대한 파라미터와 긴 문맥을 처리하기 때문이다. 모델 파라미터가 매우 커지면서 전체 가중치를 칩 안에 유지하기 어려워졌다. 추론 과정에서는 각 가중치가 제한적으로 사용된 뒤 새로운 데이터가 다시 필요해지는 경우도 많다. 재사용성은 낮아지고, 캐시는 처음 데이터를 가져오는 비용을 충분히 상쇄하기 어렵다. 그 결과 시스템은 D램이나 HBM에서 데이터를 반복해서 읽어온다.
문맥이 길어질수록 부담도 커진다. KV 캐시*는 문맥 길이에 비례해 커지고, 어텐션* 연산에서는 계산량과 메모리 접근량이 함께 늘어난다. 긴 문맥을 다루는 에이전트는 작업 단계마다 상태 정보를 다시 불러와야 한다. 이런 에이전트가 대규모로 동시에 작동하면, 기존 DDR이나 GDDR 중심의 메모리 구조만으로는 데이터 흐름을 감당하기 어렵다.
* 어텐션(Attention): AI 모델이 입력 문맥 안에서 어떤 정보에 더 주목할지 계산하는 메커니즘. 트랜스포머 구조의 핵심이며, 긴 문맥을 다룰수록 연산량과 메모리 접근 부담이 커진다.
최근 등장한 플래시 어텐션*, 페이지드 어텐션*, 추측 디코딩* 같은 최적화 기법도 이 병목을 줄이기 위해 나왔다*. 접근 방식은 다르지만, 목표는 같다. 메모리 접근량과 데이터 이동을 줄이는 것이다. 이들 기법은 연산 다이와 D램 사이를 오가는 데이터를 줄여 추론 과정의 메모리 부담을 낮춘다. 다만 메모리 접근을 효율화하더라도, 데이터 이동에 수반되는 물리적 비용까지 없앨 수는 없다. 반도체 설계의 방향은 분명하다. 데이터를 연산이 일어나는 트랜지스터 가까이에 둬야 한다. 트랜스포머가 확산할수록 데이터와 연산 사이의 물리적 거리를 줄이는 설계가 더 중요해진다.
* 페이지드 어텐션(Paged Attention): KV 캐시를 페이지 단위로 관리해 메모리 사용 효율을 높이는 어텐션 최적화 기법.
* 추측 디코딩(Speculative Decoding): 작은 모델이 후보 토큰을 먼저 생성하고 큰 모델이 이를 검증하는 방식으로 LLM 추론 속도를 높이는 기법.
* Tri Dao et al., “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness,” NeurIPS 2022; Woosuk Kwon et al., “Efficient Memory Management for Large Language Model Serving with PagedAttention,” SOSP 2023; Yaniv Leviathan, Matan Kalman, and Yossi Matias, “Fast Inference from Transformers via Speculative Decoding,” ICML 2023.
HBM과 데이터 공급 아키텍처
HBM(High Bandwidth Memory)은 이 문제에 대응한 첫 번째 본격적인 구조적 해법으로, 오늘날 AI 가속기의 성능을 뒷받침하는 주요 메모리 계층으로 자리 잡았다.
HBM은 여러 개의 D램 다이를 수직으로 적층하고, TSV*와 인터포저*를 통해 연산 장치와 연결하는 구조를 사용한다. 이를 통해 연산 장치와 메모리 사이의 거리는 센티미터 단위에서 밀리미터 단위로 크게 줄어든다. 그 결과 대역폭은 대폭 향상되고, 데이터 전송에 필요한 에너지는 감소한다. 지난 10년간 AI 가속기가 비약적으로 발전한 배경에도 이러한 구조가 있었다.
* 인터포저(Interposer): GPU, HBM 등 여러 반도체 칩을 하나의 패키지 안에서 연결하는 기판 역할의 구조물. 칩 간 데이터 이동 경로를 짧고 넓게 만드는 데 쓰인다.
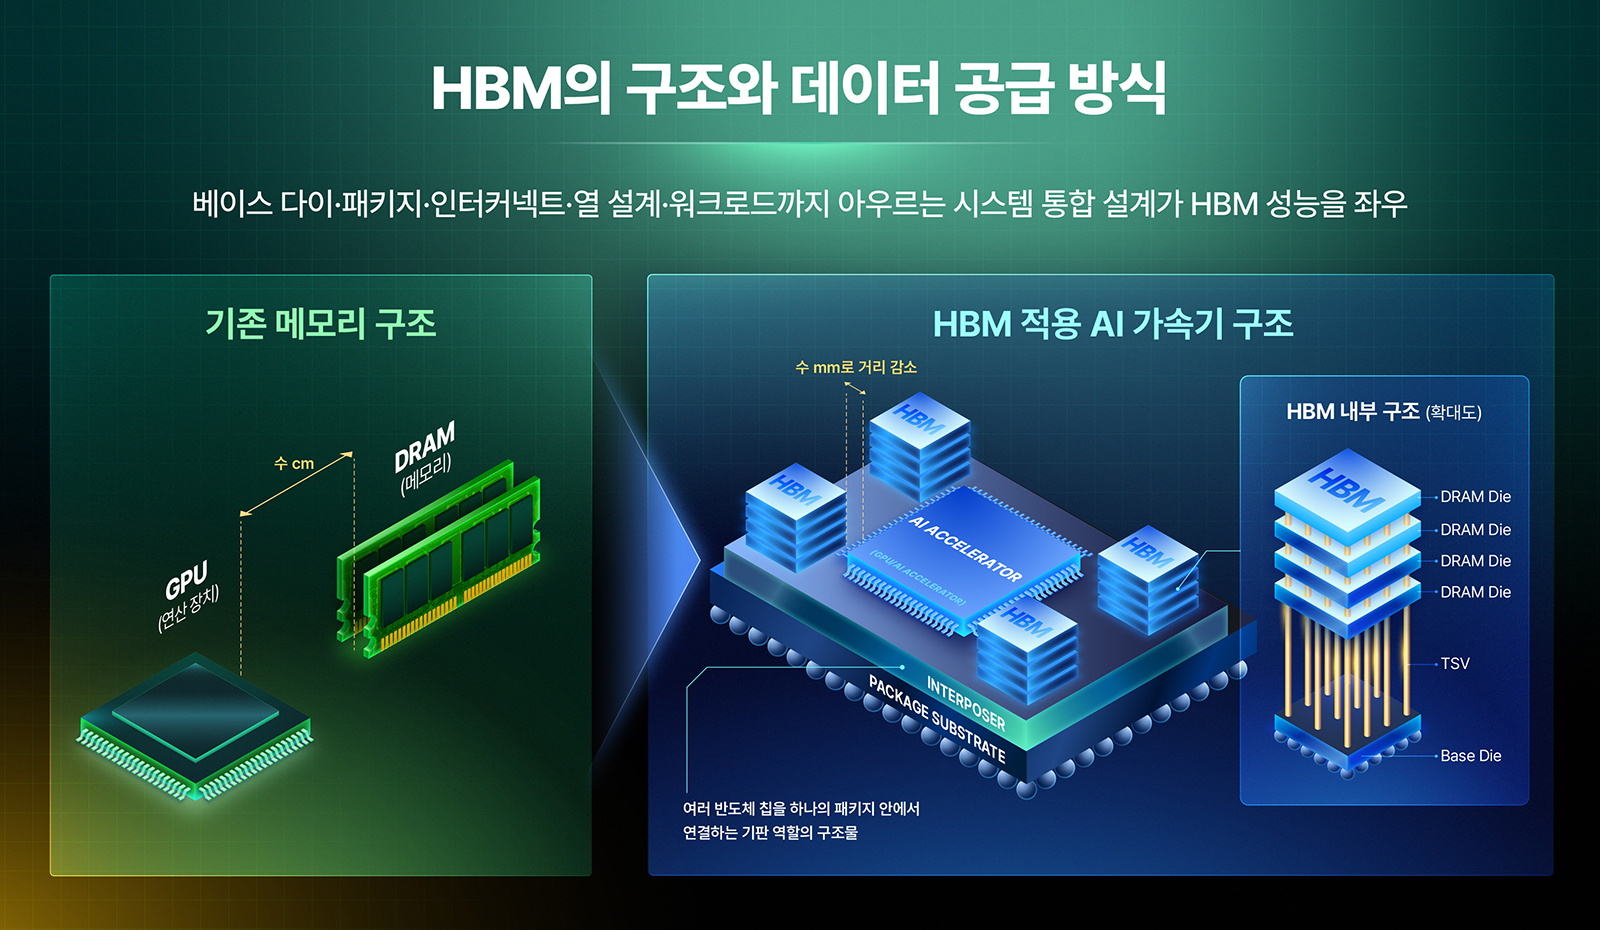
실제 제품 개발 현장에서도 이러한 설계 과제는 반복적으로 확인됐다. 저자는 AMD에서 2015년 HBM을 적용한 GPU 개발에 참여했고, 이후 인텔(Intel)에서는 47개의 칩렛*과 4개의 HBM2e 스택을 하나의 패키지에 통합한 Ponte Vecchio 개발을 이끌었다*. 이 과정에서 신호 무결성, 전력 공급, 발열, 기계적 안정성과 같은 세부 요소가 실제 성능과 제품 완성도를 좌우한다는 점을 확인했다.
* Intel official materials on Ponte Vecchio architecture.
HBM은 AI 가속기의 데이터 공급 문제를 상당 부분 풀어왔다. 하지만 앞으로의 과제는 더 까다롭다. HBM 대역폭은 연산 다이 주변에 확보할 수 있는 인터페이스 면적, 신호 전송 속도, 전력 공급, 열 설계의 영향을 함께 받는다. 스택 내부에서도 제약이 생긴다. D램 다이를 여러 층으로 쌓고 TSV와 배선을 따라 신호를 주고받다 보면, 신호가 지나는 경로가 길고 복잡해지면서 손실과 간섭이 늘어난다. 이는 전력 소모와 발열에도 영향을 준다. 세대가 올라갈수록 단순히 대역폭을 더하는 방식만으로는 성능 향상을 이어가기 어려워지는 이유도 여기에 있다.
이 때문에 업계의 관심은 메모리에서 시스템 전체로 이동하고 있다. HBM 설계의 범위도 베이스 다이*, 패키지, 인터커넥트, 열 설계, 실제 워크로드 특성까지 함께 다루는 방향으로 넓어졌다. 메모리와 연산 장치를 하나의 시스템 안에서 얼마나 짧고 안정적인 경로로 연결하느냐가 성능 차이를 만든다.
첨단 패키징과 메모리 통합
메모리가 시스템 성능의 중심으로 부상하면서 패키징의 역할도 달라지고 있다. 이제 패키징은 후공정 조립이 아니라, 연산 다이와 메모리 스택, 인터커넥트, 전력 공급 구조는 물론 발생한 열을 외부로 배출하는 방열 경로를 함께 설계하는 시스템 아키텍처의 일부다. 각 요소를 어떻게 배치하고 연결하느냐에 따라 대역폭, 지연시간, 에너지 효율, 신뢰성이 달라진다.
2.5D와 3D 통합, 칩렛, 인터포저, 하이브리드 본딩*은 모두 데이터와 연산 사이의 물리적 거리를 줄이기 위한 접근이다. 여러 기능 블록을 하나의 패키지에 넣는 것만으로는 충분하지 않다. 성능과 효율은 각 블록을 얼마나 짧고 안정적인 경로로 연결하는지, 그 연결 구조가 실제 워크로드의 데이터 흐름과 얼마나 잘 맞는지에서 갈린다.
대규모 칩 프로젝트에서는 작은 세부 문제가 성능 저하나 신뢰성 문제로 이어지는 경우가 많다. PCB 공진*은 특정 주파수에서 신호와 전원 공급을 불안정하게 만들고, 마이크로범프* 피로는 반복되는 열과 기계적 스트레스로 접점 신뢰성을 떨어뜨린다. 서로 다른 다이 사이에 열이 영향을 주고받으면 특정 영역의 온도가 높아져 성능 저하나 수명 문제로 이어질 수 있다. 메모리 중심 설계는 이런 세부 문제를 얼마나 정교하게 잡아내고 설계에 반영하느냐에서 차이가 난다.
* 마이크로범프 피로(Microbump fatigue): 반도체 다이 사이를 연결하는 미세 접점인 마이크로범프가 반복적인 온도 변화와 기계적 스트레스를 받으면서 손상이 누적되는 현상. 접점의 연결 신뢰성과 수명에 영향을 줄 수 있다.
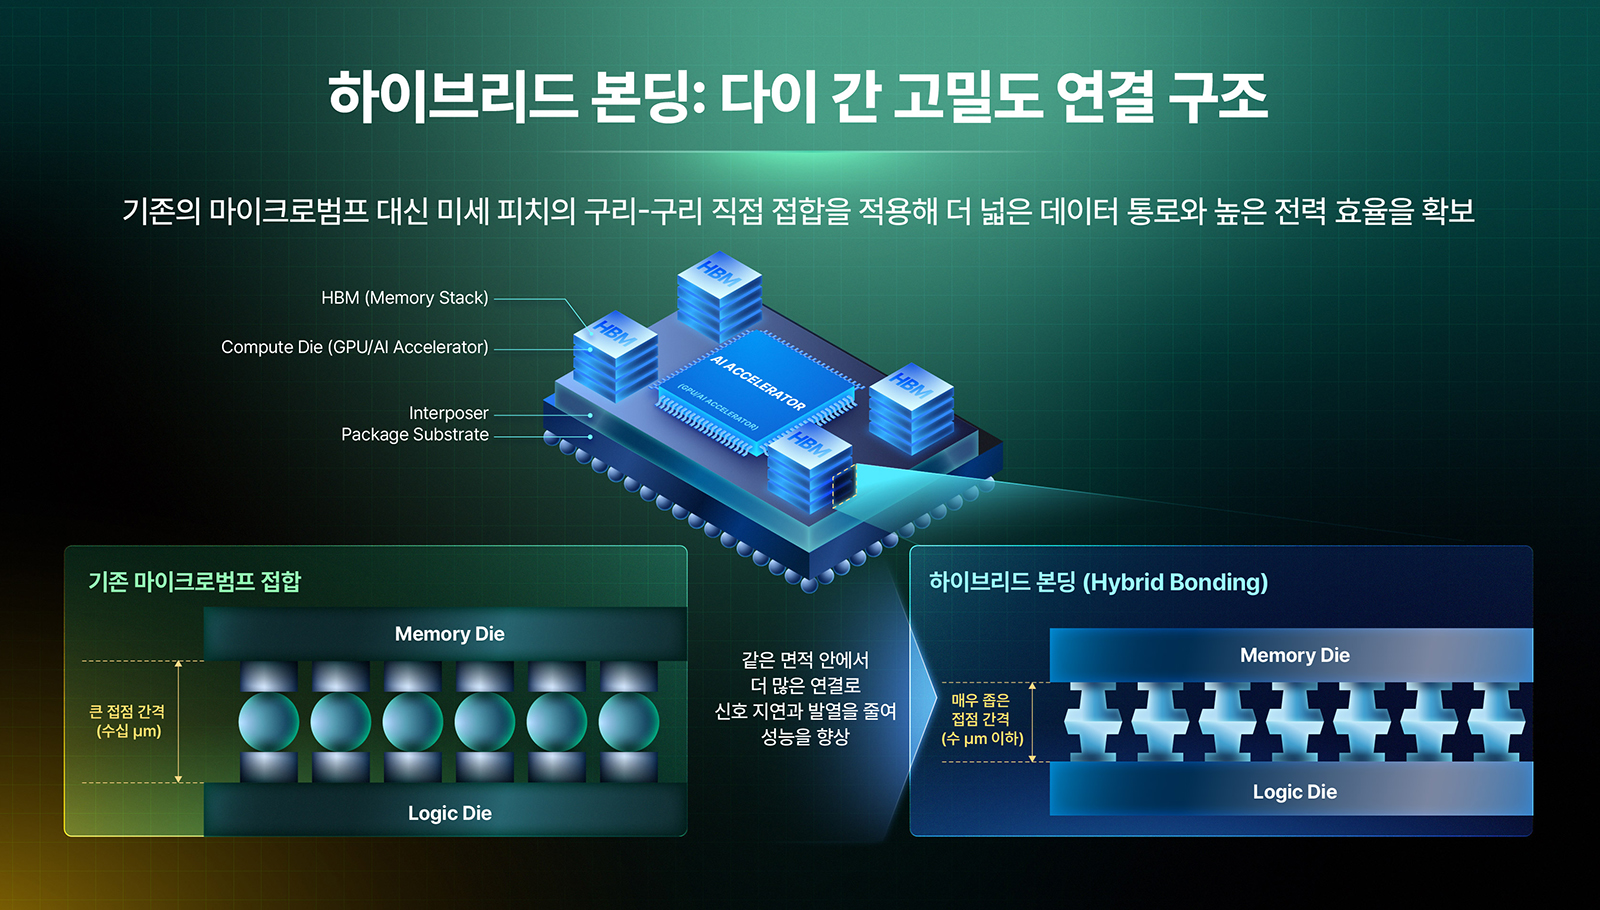
하이브리드 본딩은 다이 사이의 연결을 더 짧고 촘촘하게 만드는 기술이다. 기존의 마이크로범프 대신 미세 피치의 구리-구리 직접 접합을 적용하면 같은 면적 안에서 더 많은 연결을 만들 수 있다. 신호가 지나는 접점과 배선에서 생기는 전기적 부담을 낮추고, 같은 면적에서 더 넓은 데이터 통로를 확보한다. 마이크로범프가 고속 신호 전달 과정에서 병목이 되기도 하는 반면, 하이브리드 본딩은 다이 사이를 더 짧고 촘촘하게 연결해 비트당 에너지 소비를 낮춘다. 그 결과 로직과 메모리를 더 긴밀하게 통합한 고집적 3D 구조가 실질적인 대안으로 떠오른다.
이와 함께 칩과 패키지, 시스템 사이의 경계도 점차 희미해진다. 과거에는 GPU의 연산 성능과 HBM 대역폭이 시스템 경쟁력을 판단하는 주요 기준이었다. 이제는 제한된 면적 안에서 연산, 메모리, 인터커넥트를 어떤 비율로 배치할지까지 함께 따져야 한다. 어떤 워크로드에는 더 큰 메모리 용량이 맞고, 어떤 워크로드에는 같은 면적에서 더 많은 데이터를 오가게 하는 짧고 넓은 연결 경로가 더 필요하다. AI 반도체는 범용 부품을 조합하는 방식에서 벗어나, 실제 워크로드 특성에 맞춘 통합 설계 중심으로 이동하고 있다.
PIM과 데이터 근접 연산
지금까지 살펴본 기술은 한 방향으로 모인다. 데이터를 연산 장치에 더 가까이 배치하는 것이다. 더 큰 캐시, HBM, 하이브리드 본딩을 포함한 첨단 패키징은 모두 데이터와 연산 사이의 물리적 거리를 줄이기 위한 접근이다. 여기서 한 걸음 더 나아가면 데이터 이동 자체를 더 줄이는 접근이 나온다. 데이터를 연산 장치로 옮기는 대신, 데이터가 있는 위치에서 일부 연산을 직접 수행하는 방식이다.
PIM*은 이 흐름의 연장선에 있는 기술이다. 기존 컴퓨팅 구조에서는 데이터를 연산 장치로 가져와 처리한다. 반면 PIM은 일부 연산을 데이터가 있는 곳으로 옮긴다. D램 내부나 HBM 베이스 다이, 또는 다른 메모리 기술 근처에서 일부 연산을 수행해 메모리 내 불필요한 데이터 왕복을 줄인다.
PIM은 CPU나 GPU를 대체하기보다, 데이터 이동 비용이 연산 비용보다 큰 작업에서 기존 가속기를 보완하는 역할에 적합하다. 예를 들어 많은 데이터가 담긴 대규모 텐서*에 대해 비교적 단순한 연산을 반복하는 경우, 연산 자체보다 데이터를 멀리 옮기는 비용이 전체 시스템 효율에 더 큰 영향을 미칠 수 있다. 이런 작업에서는 메모리 내부 또는 메모리 인근에서 연산을 수행함으로써, 워크로드에 따라 에너지 소비를 10~100배까지 줄일 수 있다*. PIM의 강점은 연산 성능 자체를 높이는 것보다 데이터 이동을 줄이는 데서 더 잘 드러난다.
* Raja Koduri, “The Shift Toward Memory,” shared for SK hynix AI Ecosystem series, 2026.
이러한 변화는 메모리 계층을 시스템 설계의 출발점으로 끌어올리고 있다. 어떤 데이터가 어디에 위치할지, 어떤 연산을 데이터가 있는 곳에서 처리할지, 어떤 경우에만 중앙 가속기로 전달할지에 따라 시스템 효율은 크게 달라진다. 앞으로의 메모리 중심 아키텍처*는 데이터를 연산 장치로 옮기기보다, 연산을 데이터가 있는 위치로 보내는 방향에 가까워질 것이다.
물론 해결해야 할 과제도 적지 않다. 연산 기능을 메모리 스택 내부로 가져올 때 가장 큰 난관 가운데 하나는 열 관리다. 하이브리드 본딩은 인터페이스에서 발생하는 전력 소모를 줄일 수 있지만, 온도에 민감한 D램 인근에 로직이 배치되면 발생한 열을 어떻게 효과적으로 배출할 것인지가 까다로운 과제로 남는다. 제한된 공간 안에서 대역폭, 전력 효율, 신뢰성, 방열 성능을 동시에 확보해야 하기 때문이다.
PIM의 구현에는 메모리와 연산, 패키징, 열 설계, 소프트웨어를 유기적으로 연결하는 시스템 차원의 접근이 필요하다. 데이터가 있는 곳에서 연산한다는 개념 자체는 단순하지만, 이를 실제 제품으로 구현하려면 각 요소를 정교하게 조율하는 통합 설계 역량이 필수적이다.
AI 반도체 경쟁의 새로운 기준
AI 실리콘의 중심은 개별 연산 다이를 넘어 패키지와 시스템 전체로 확장되고 있다. 어느 한 요소의 개선만으로는 성능과 효율의 한계를 뛰어넘기 어려운 시대가 됐다.
트랜지스터 수준의 혁신 역시 여전히 필요하다. 작동 전압과 누설 전류를 낮추고, 연산 효율을 높이는 기술은 계속 발전해야 한다. 다만 다음 단계의 성능 향상을 단순히 더 많은 연산 회로를 집적하는 방식만으로 기대하기는 어렵다. 이제는 확보한 연산 능력을 얼마나 효율적으로 활용할 수 있는지가 더 큰 과제다.
여기서 세 가지 질문이 남는다. 데이터를 연산 장치 가까이에 얼마나 배치할 수 있는가. 데이터 이동이 불가피할 때 얼마나 빠르고 효율적으로 전달할 수 있는가. 그리고 한 번 가져온 데이터에서 얼마나 많은 연산 가치를 끌어낼 수 있는가. 앞으로의 AI 반도체 혁신은 이 세 가지 질문에 대한 답을 찾아가는 과정이 될 것이다.
반도체 산업의 경쟁 기준도 달라지고 있다. CPU 시대가 프로세서 성능 경쟁의 시대였다면, GPU 시대는 대규모 병렬 처리 경쟁의 시대였다. AI 시대에는 연산, 메모리, 패키징, 인터커넥트, 소프트웨어를 하나의 시스템으로 묶고 불필요한 데이터 이동을 줄이는 설계가 경쟁력을 가른다.
메모리 중심 아키텍처의 본질은 AI 시스템의 데이터 저장·전달·처리 전 과정에서 메모리를 설계의 출발점으로 삼는 데 있다. HBM은 데이터를 연산 장치 가까이 공급하고, 첨단 패키징은 메모리와 연산 장치 사이의 연결을 더 촘촘하게 만든다. PIM은 데이터가 있는 위치에서 연산을 수행해 데이터 이동 자체를 줄인다.
AI 반도체의 경쟁력은 데이터를 가까이 두고, 불필요한 이동을 줄이며, 같은 데이터에서 더 많은 연산 가치를 끌어내는 설계에서 갈린다. 물리 법칙 앞에서는 어떤 기술도 예외일 수 없다. 성능과 효율의 차이는 치밀한 엔지니어링과 끈질긴 최적화에서 나온다.
다음 편에서는 이 흐름이 피지컬 AI와 온디바이스 AI 환경에서 어떻게 이어지는지 살펴본다. AI가 클라우드와 데이터센터를 넘어 엣지, 디바이스, 물리 세계로 확장될수록 성능 차이는 더 빠른 연산 장치보다, 필요한 데이터를 가까운 곳에 두고 안정적으로 공급하는 설계가 차이를 만든다.
※본 콘텐츠는 AI/반도체 산업에 관한 인사이트를 제공하는 외부 전문가 칼럼 콘텐츠로, SK하이닉스의 공식 입장과는 다를 수 있습니다.