AI가 다루는 데이터의 양이 폭발적으로 늘면서 데이터 병목 현상이 새로운 과제로 떠올랐다. 다음 세대의 메모리 기술은 해결책을 제시할 수 있을까? 이 질문에 대한 SK하이닉스의 대답을 직접 확인해볼 수 있는 자리가 마련됐다.
SK하이닉스가 지난 12일부터 15일까지 미국 캘리포니아주 새너제이(San Jose)에서 열린 ‘OCP 글로벌 서밋 2026(OCP Global Summit 2026)’에 참가해, 차세대 메모리 설루션을 대거 공개하고 AI 시대 메모리 기술이 나아가야 할 방향을 제시했다.
OCP 글로벌 서밋은 데이터센터 하드웨어의 설계와 사양을 공유하고 표준화하는 기술 컨퍼런스다. 올해는 AI 발전을 뒷받침할 인프라 기술이 주요 화두로 떠오른 가운데, SK하이닉스가 제안한 새로운 서버 시스템이 큰 관심을 모았다. SK하이닉스는 이를 위해 준비 중인 차세대 설루션들을 실제 시스템 레벨에서 시연해 실현 가능성을 입증했고, 한발 앞선 기술 리더십도 다시 한번 확인했다.
‘CXL 풀드 메모리’ 기반 차세대 서버 시스템 제안… 데모 시연 통해 개선 효과 직접 확인
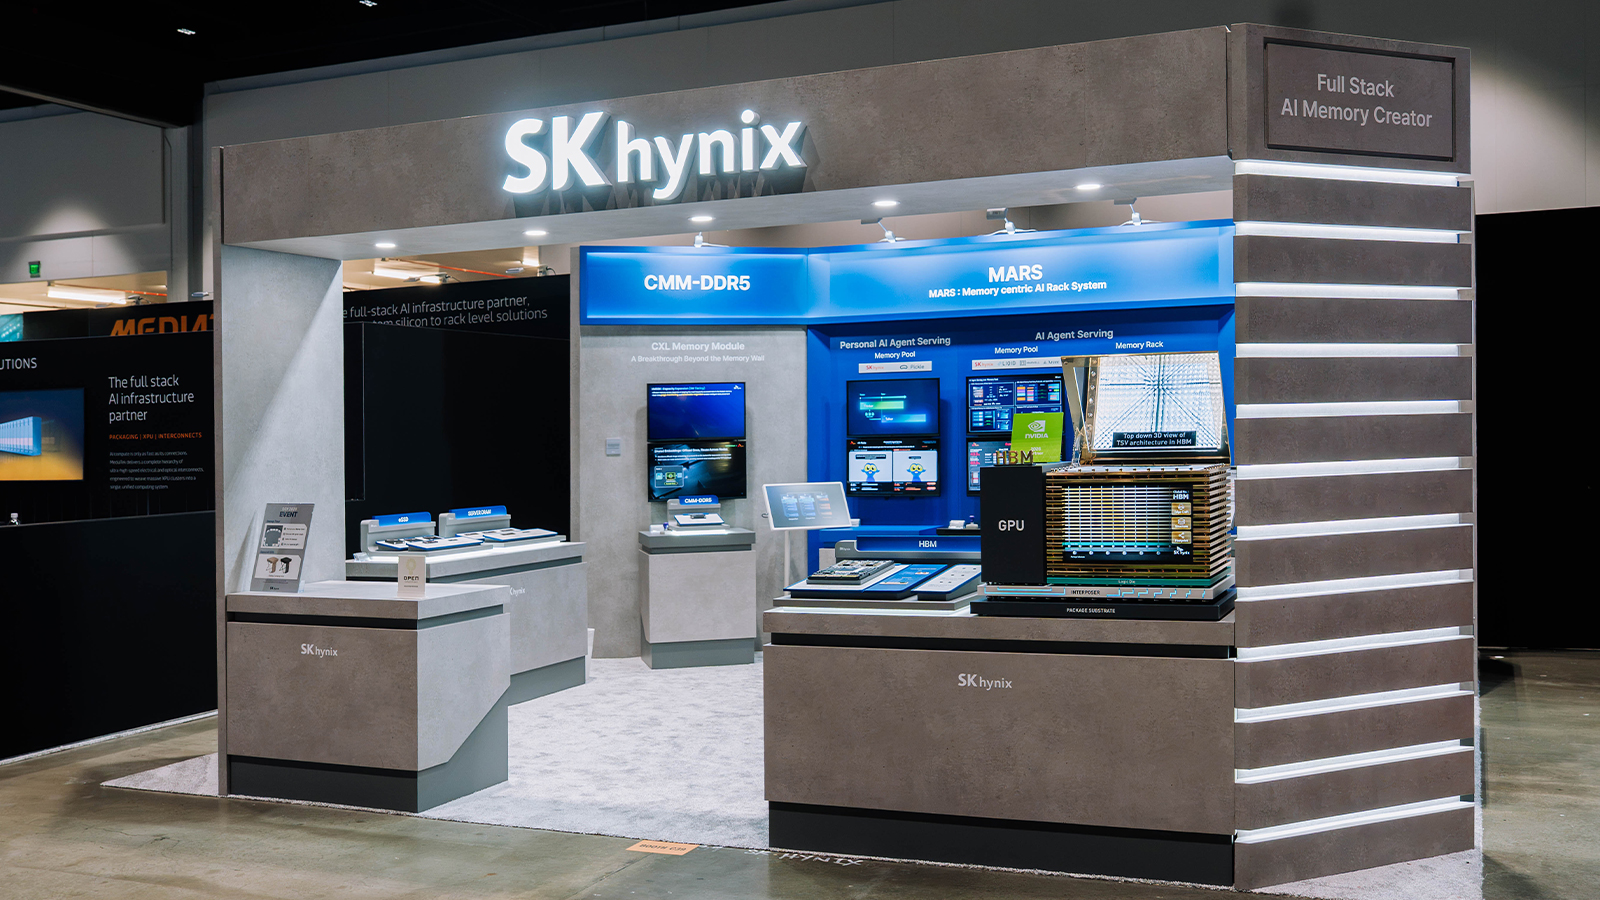
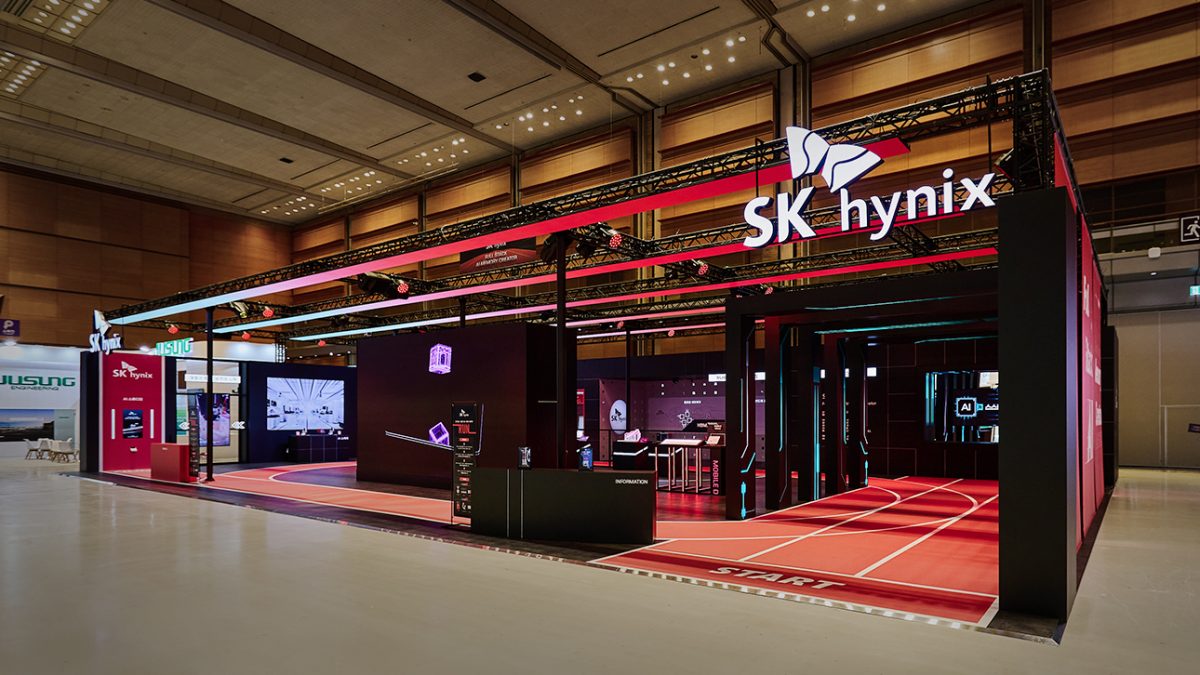
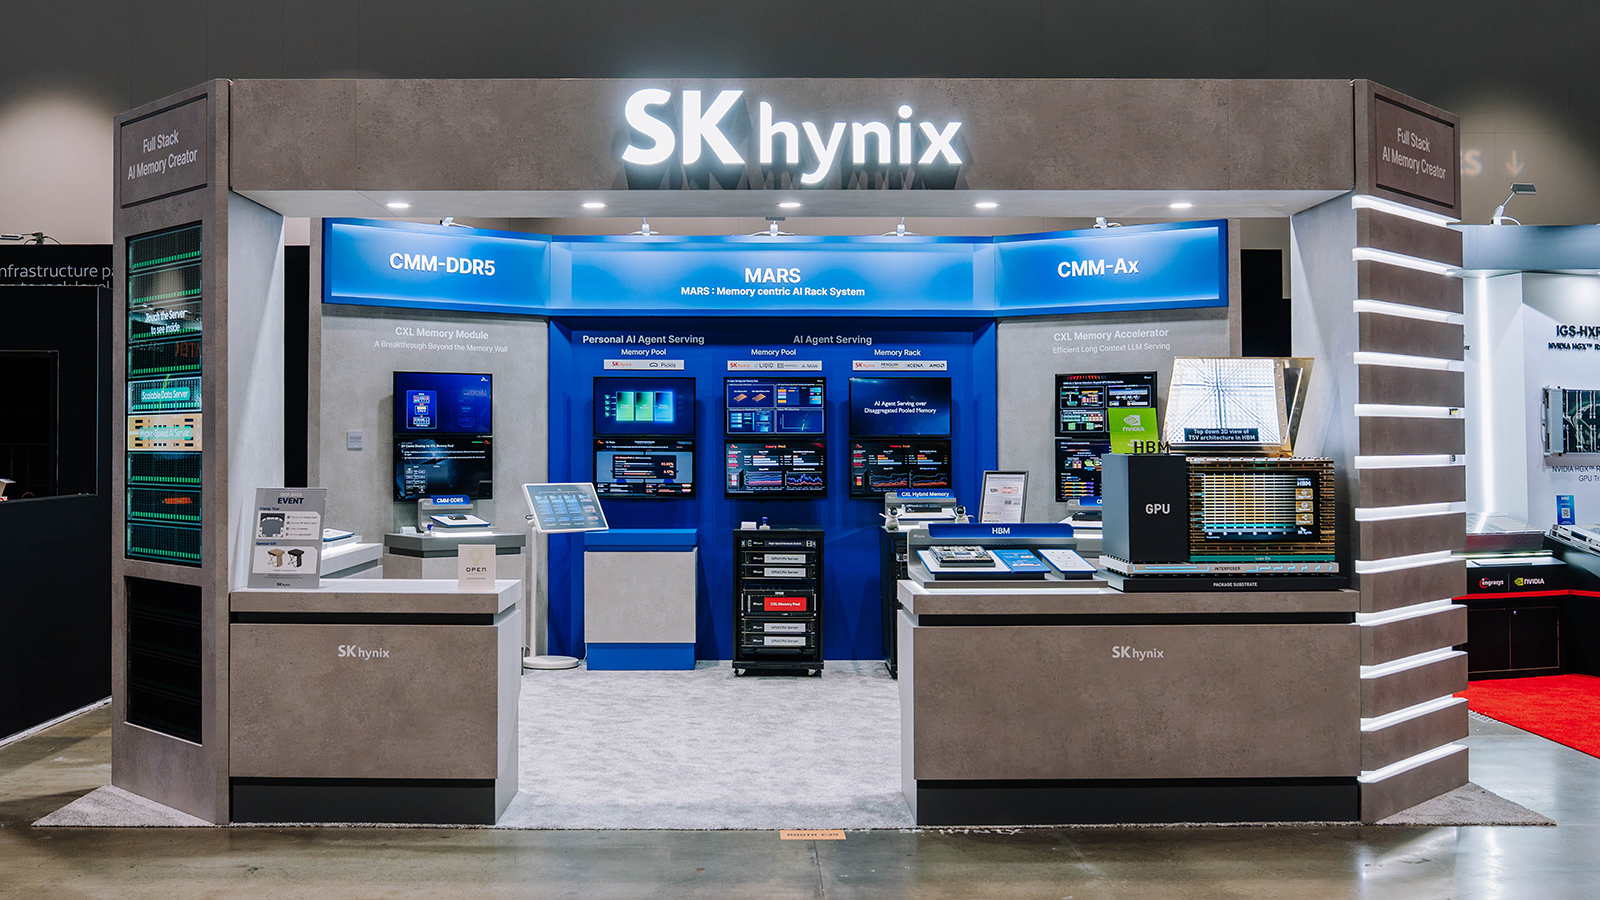
▲ SK하이닉스의 전시 부스
SK하이닉스는 견고한 그레이 프레임과 네온 블루 컬러의 조명을 적절히 배치한 부스 콘셉트로, 차세대 메모리 설루션의 핵심 가치인 ‘신뢰성’과 ‘효율성’을 시각적으로 구현했다. 전시 공간은 전 · 후면으로 나눴다. 전면에는 현재 주력 제품을 소개하는 ‘메모리 섹션’을 배치해 관람객들의 시선을 사로잡았고, 후면의 넓은 공간에 마련한 ‘시스템 데모’ 섹션에서는 차세대 서버 생태계를 구성할 SK하이닉스의 메모리 설루션들을 자세히 살펴볼 수 있도록 했다.
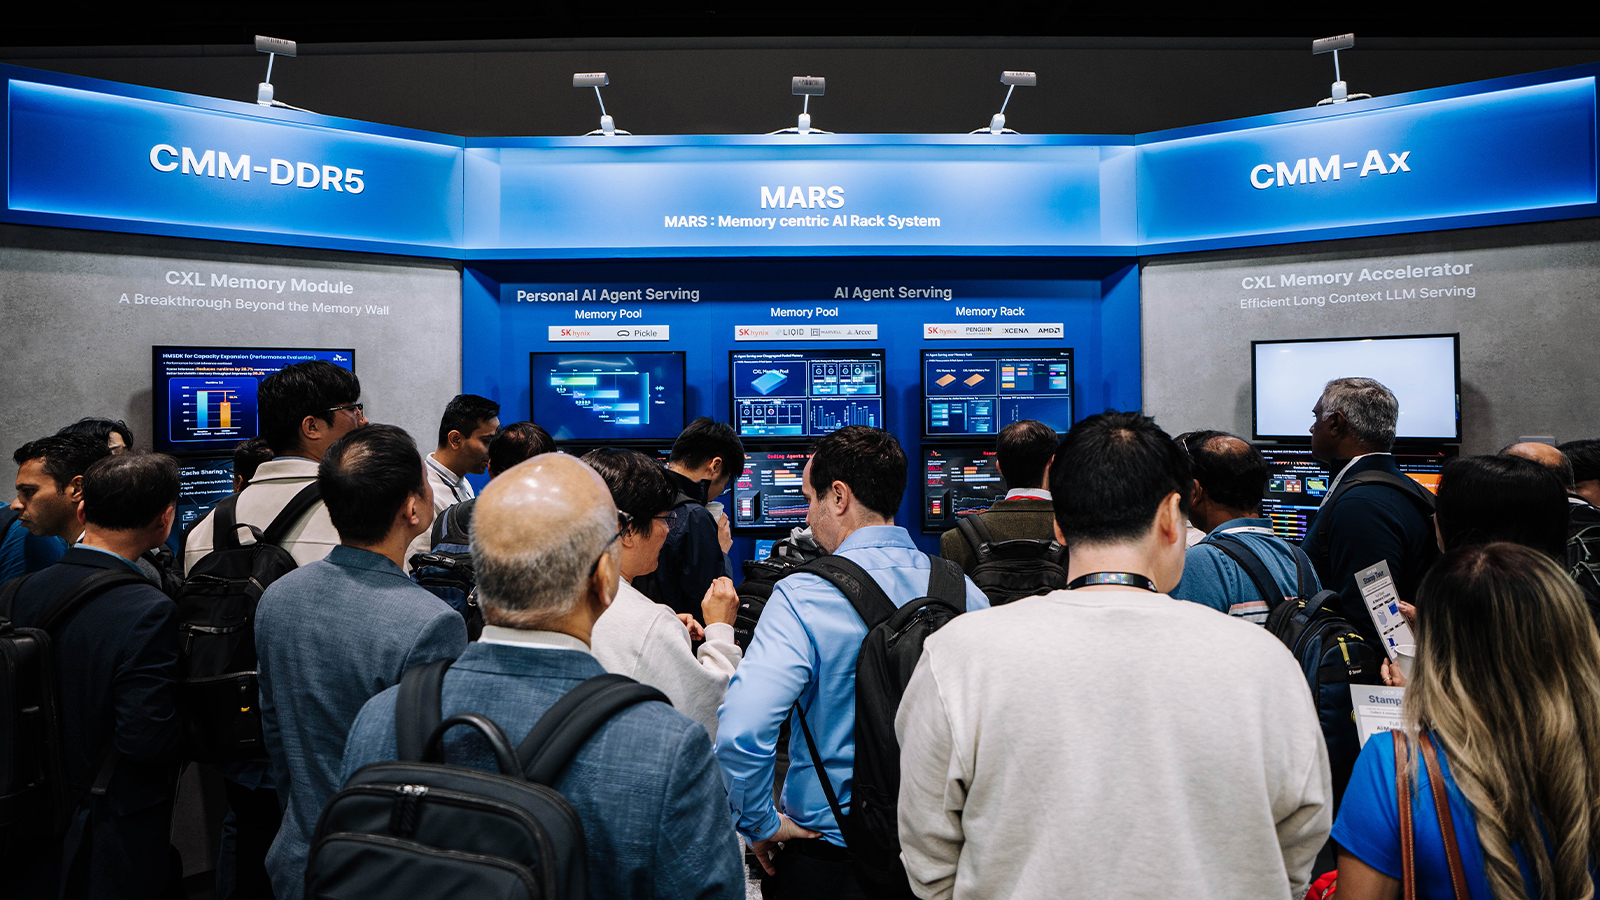
▲ ‘시스템 데모’ 섹션을 둘러보고 있는 관람객들
‘시스템 데모’ 섹션에서는 왼쪽부터 ▲CMM-DDR5 ▲MARS ▲CMM-Ax 등 세 가지 설루션이 차례로 소개됐다. ‘CMM(CXL* Memory Module)-DDR5’는 CXL 인터페이스 규격을 기반으로 여러 서버가 필요한 만큼 나눠 쓸 수 있는 메모리 풀(Pool)을 공유함으로써 자원 활용 효율을 끌어올린 메모리 설루션이다. 이번 전시에서는 CXL 3.2 기반으로 AI 워크로드에 최적화한 2세대 제품(256GB)이 공개됐다. 이 제품은 이전 세대 대비 대역폭이 2배 이상(80GB/s) 증가했고, 에너지 효율이 약 30% 개선됐다. CXL Pooled 기능까지 적용되어 데이터 집약적인 고부하 환경의 병목 현상을 효과적으로 해결할 차세대 메모리 제품으로 기대를 모으고 있다.
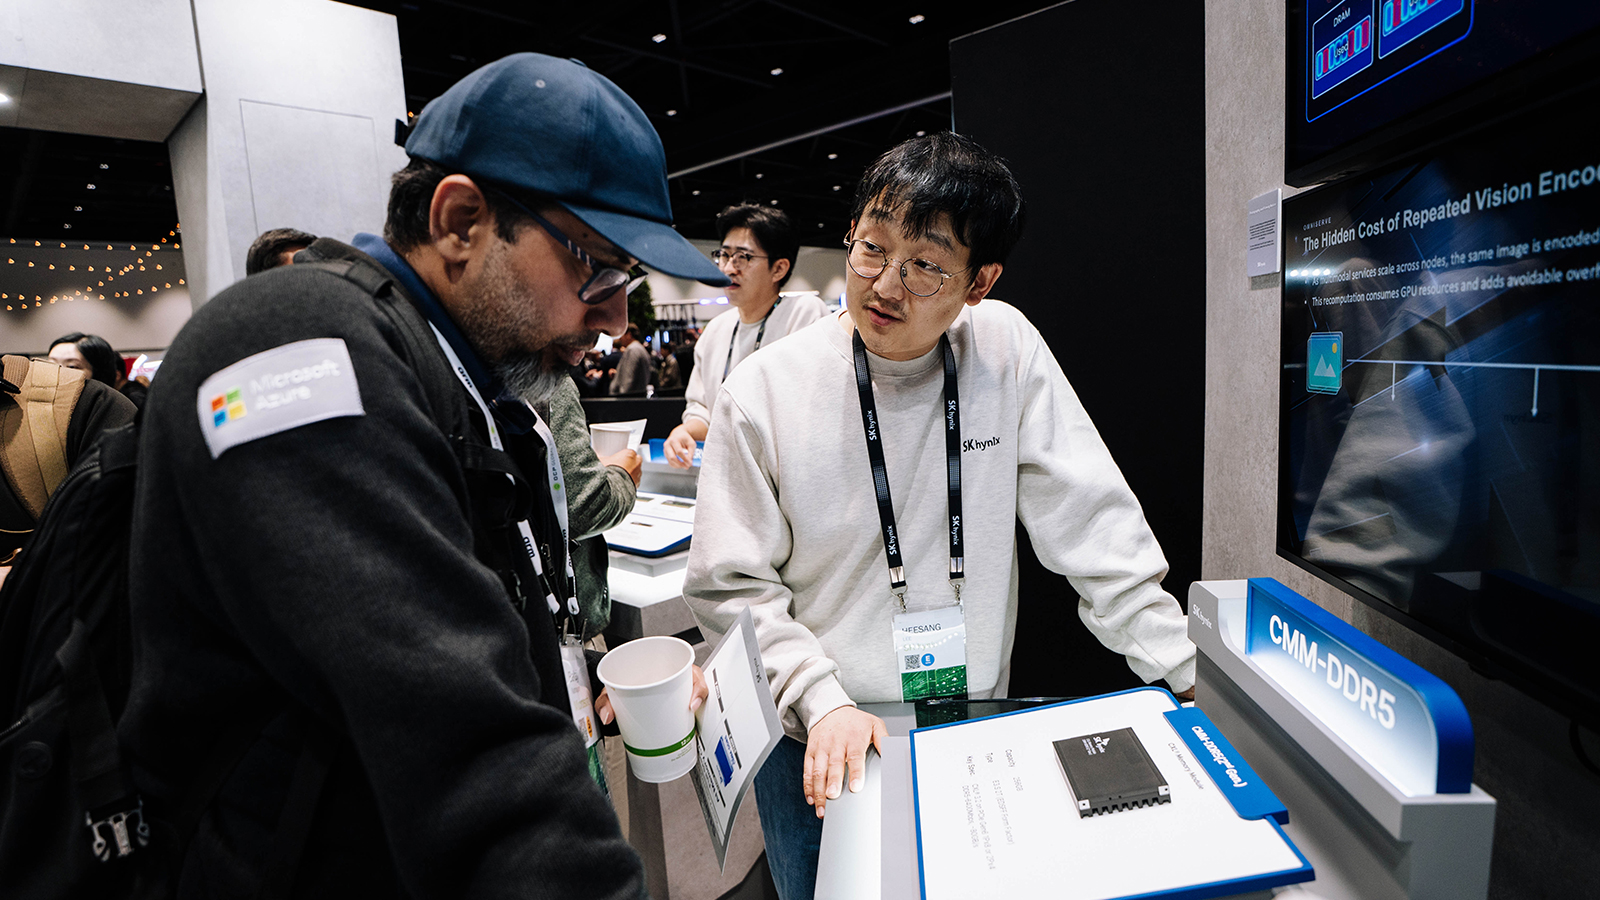
▲ CMM-DDR5 제품을 살펴보고 있는 관람객
SK하이닉스는 지난해 9월 네이버클라우드와 업무협약을 맺고, CXL 기반 메모리 설루션을 활용해 클라우드 AI 서비스의 병목 현상을 해소하기 위한 공동 작업을 이어오고 있다. 이번 데모에서는 에이전틱 AI* 환경에서의 KV 캐시* 공유 설루션과 옴니모달(Omni-Modal)* 서비스 ‘OmniServe’에서의 임베딩 공유 설루션이 실제로 유효한지 PoC* 수준에서 검증한 성과를 선보였다. 실제 고객의 시스템과 워크로드를 분석해 CXL 기반 설루션의 적용 가능성을 확인한 만큼, 본격적인 설루션 확장을 위한 발판이 마련된 셈이다.
* KV 캐시(Key Value Cache): 대규모 언어모델 기반 AI 에이전트가 텍스트를 생성할 때 이전에 계산한 결과를 저장해두는 임시 메모리. 사용자와 대화가 길어질수록, 처리할 작업이 많을수록 기하급수적으로 커져 이를 효율적으로 저장하고 처리하는 메모리 역량이 AI 에이전트의 성능에 큰 영향을 미침
* 옴니모달(Omni-Modal): 텍스트와 이미지, 음성 등 여러 형태의 데이터를 하나의 모델에서 통합 처리하는 방식
* PoC(Proof of Concept): 새로운 기술이나 개념이 실제로 작동하는지 검증하는 단계
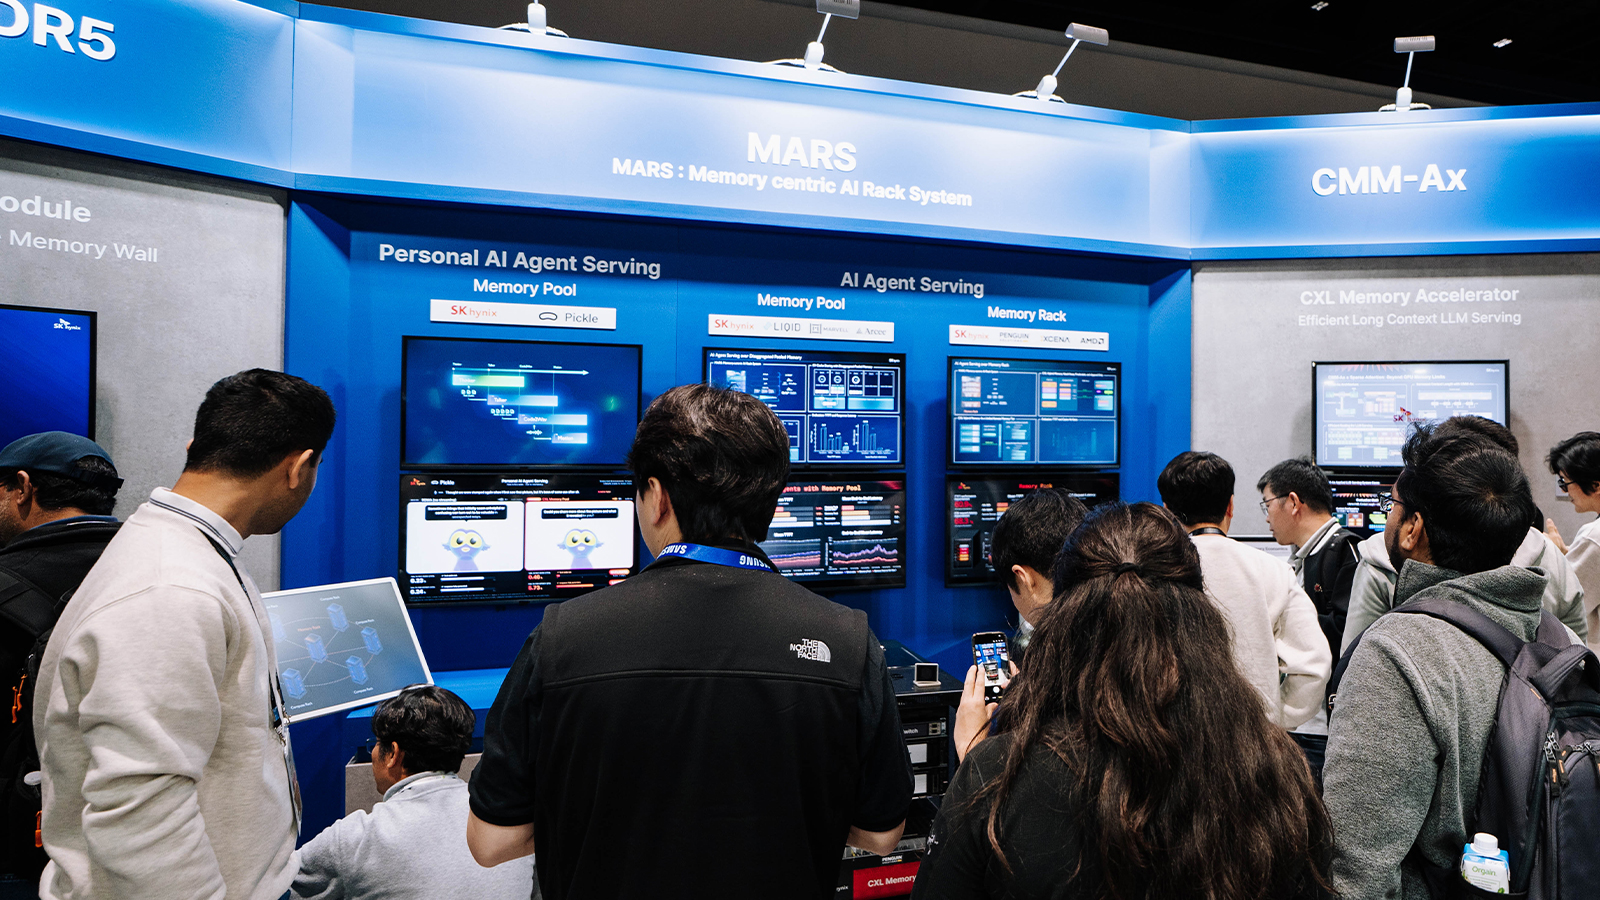
▲ MARS 관련 정보를 살펴보고 있는 관람객들
MARS(Memory Centric AI Rack System)는 메모리를 중심으로 파트너사의 설루션을 하나의 랙*에 통합해 효율을 극대화한 차세대 시스템이다. 이번 전시에서는 여러 파트너사와 함께 세 가지 데모를 선보였다.
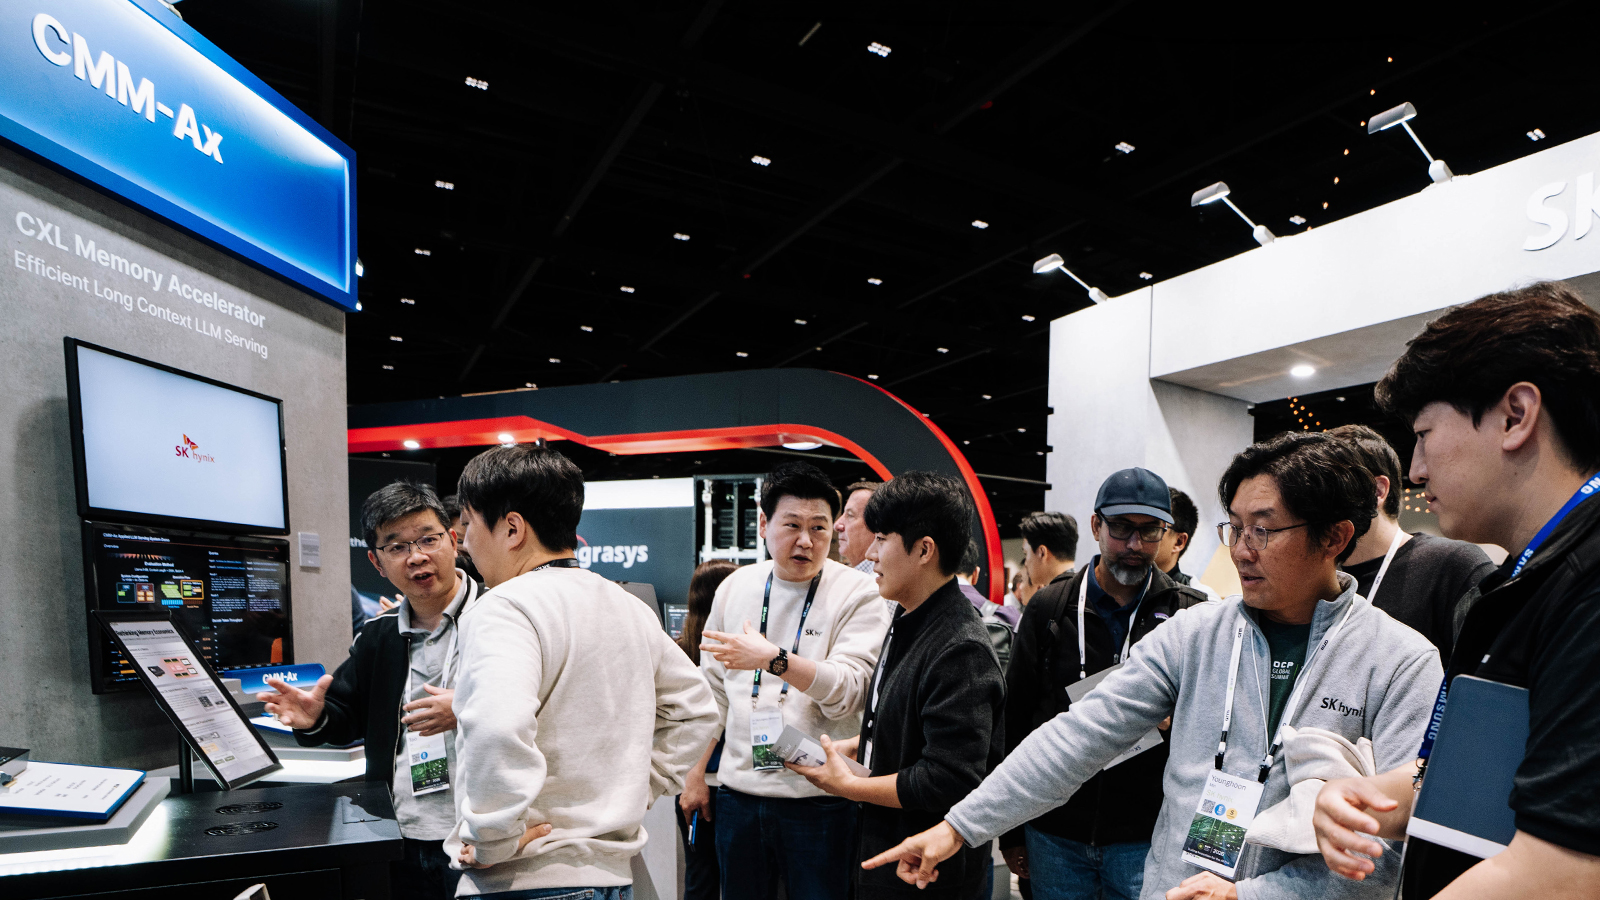
▲ CXL 풀드 메모리를 활용한 AI 에이전트 서빙 기술 시연 모습
AI 에이전트 서빙 데모에서는 아씨(Arcee), 리퀴드(Liqid), 마벨(Marvell)과 함께 풀드 메모리*를 활용해 여러 서버와 GPU를 연결한 시스템을 시연했다. 이를 통해 SK하이닉스는 CXL 풀드 메모리를 기반으로 KV 캐시를 전달하거나 재사용할 경우, 네트워크 통신을 이용하는 기존 방식보다 시스템 성능이 크게 향상된다는 점을 입증했다.
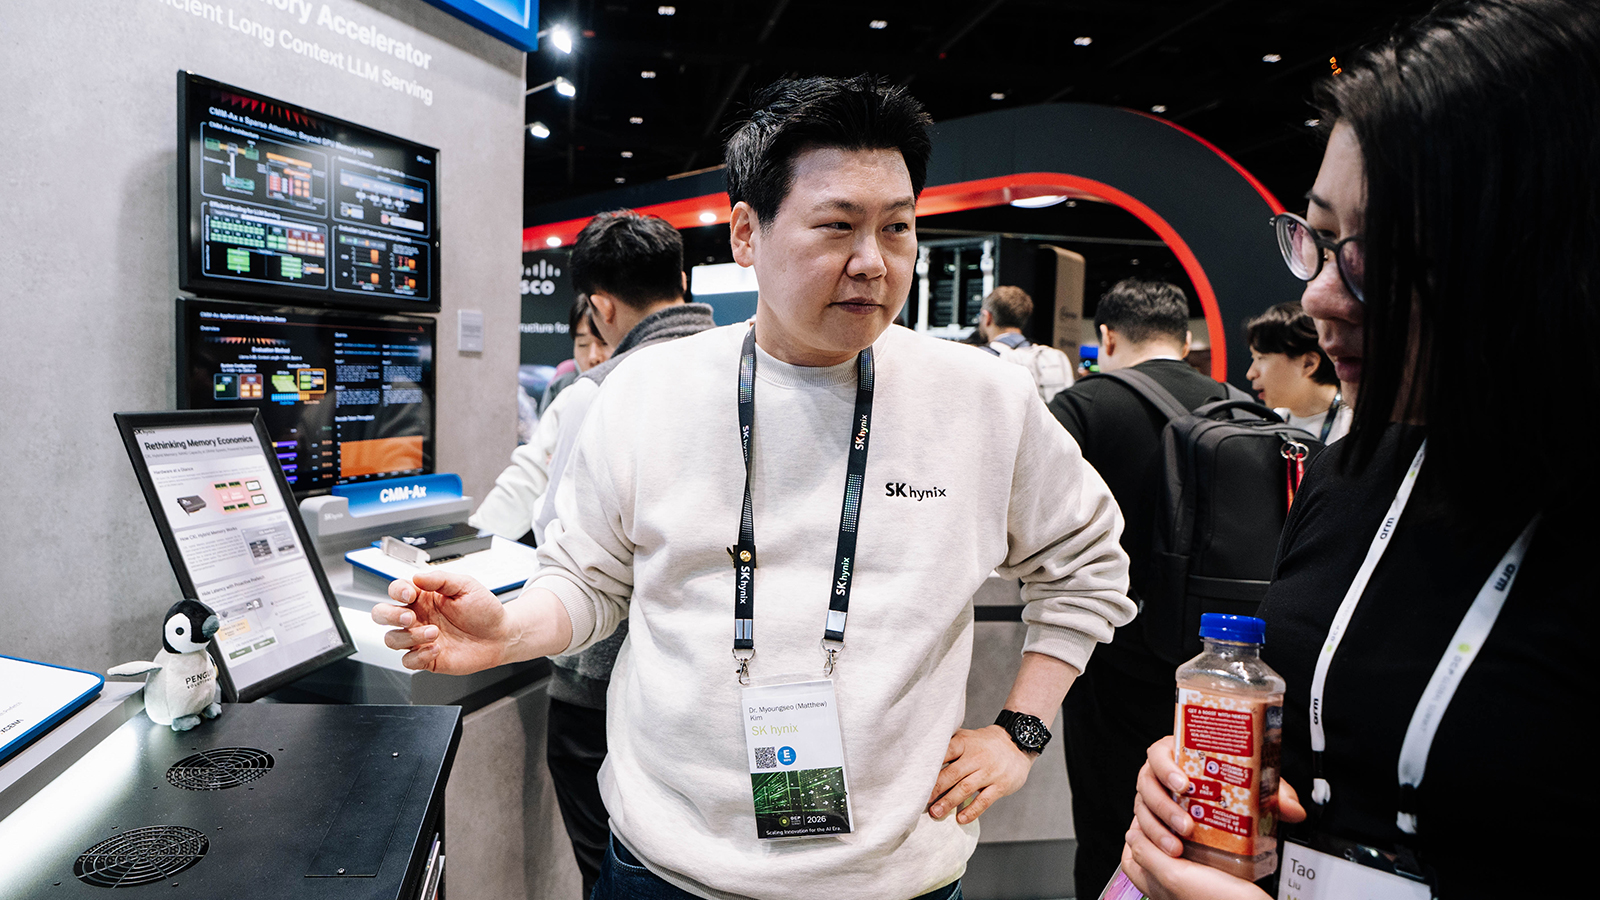
▲ CXL 하이브리드 메모리를 활용한 AI 에이전트 서빙 기술 시연 모습
AMD, 펭귄(Penguin), 엑시나(Xcena), 아씨와 함께한 데모에서는 CXL 메모리와 CXL 하이브리드 메모리*를 활용한 메모리 랙의 효용성을 보여줬다. 그 결과, 메모리 랙이 지속적으로 생성되는 대규모 KV 캐시를 효율적으로 저장하고 빠르게 재사용할 수 있음을 확인했다. 특히 기존 대화 및 작업 이력에 따라 필요한 KV 캐시를 빠르게 예측하는 특성과 필요한 KV 캐시를 미리 D램으로 가져와 빠르게 처리할 수 있는 성능을 모두 잘 보여줬으며, 전체 KV 캐시는 SSD에 저장해 빠른 읽기 성능과 대용량 스토리지를 동시에 제공할 수 있음도 입증했다.
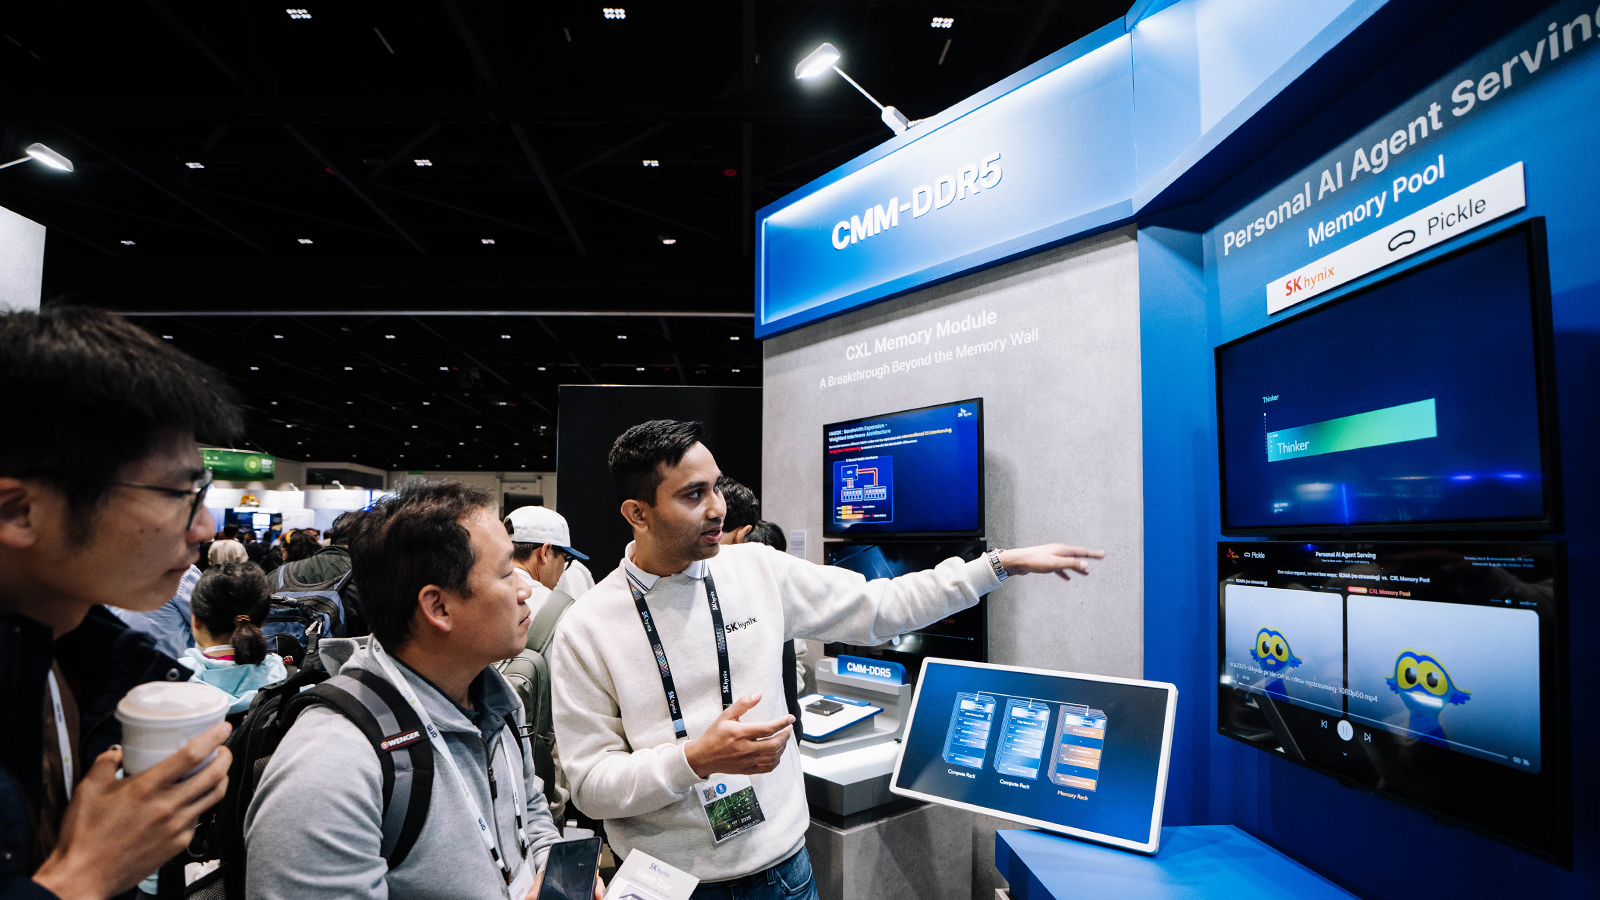
▲ 풀드 메모리로 서비스 응답 지연을 개선하는 기술 시연 모습
퍼스널 AI 에이전트 서비스 업체인 피클(Pickle)과는 풀드 메모리로 서비스 응답 지연을 개선하는 데모를 진행했다. 이를 통해 퍼스널 AI 에이전트에 필수적인 여러 AI 모델 간 데이터 전달 과정을 풀드 메모리 기반 스트리밍으로 가속해, 최종 결과를 사용자에게 더 빠르게 전달할 수 있음을 확인했다.
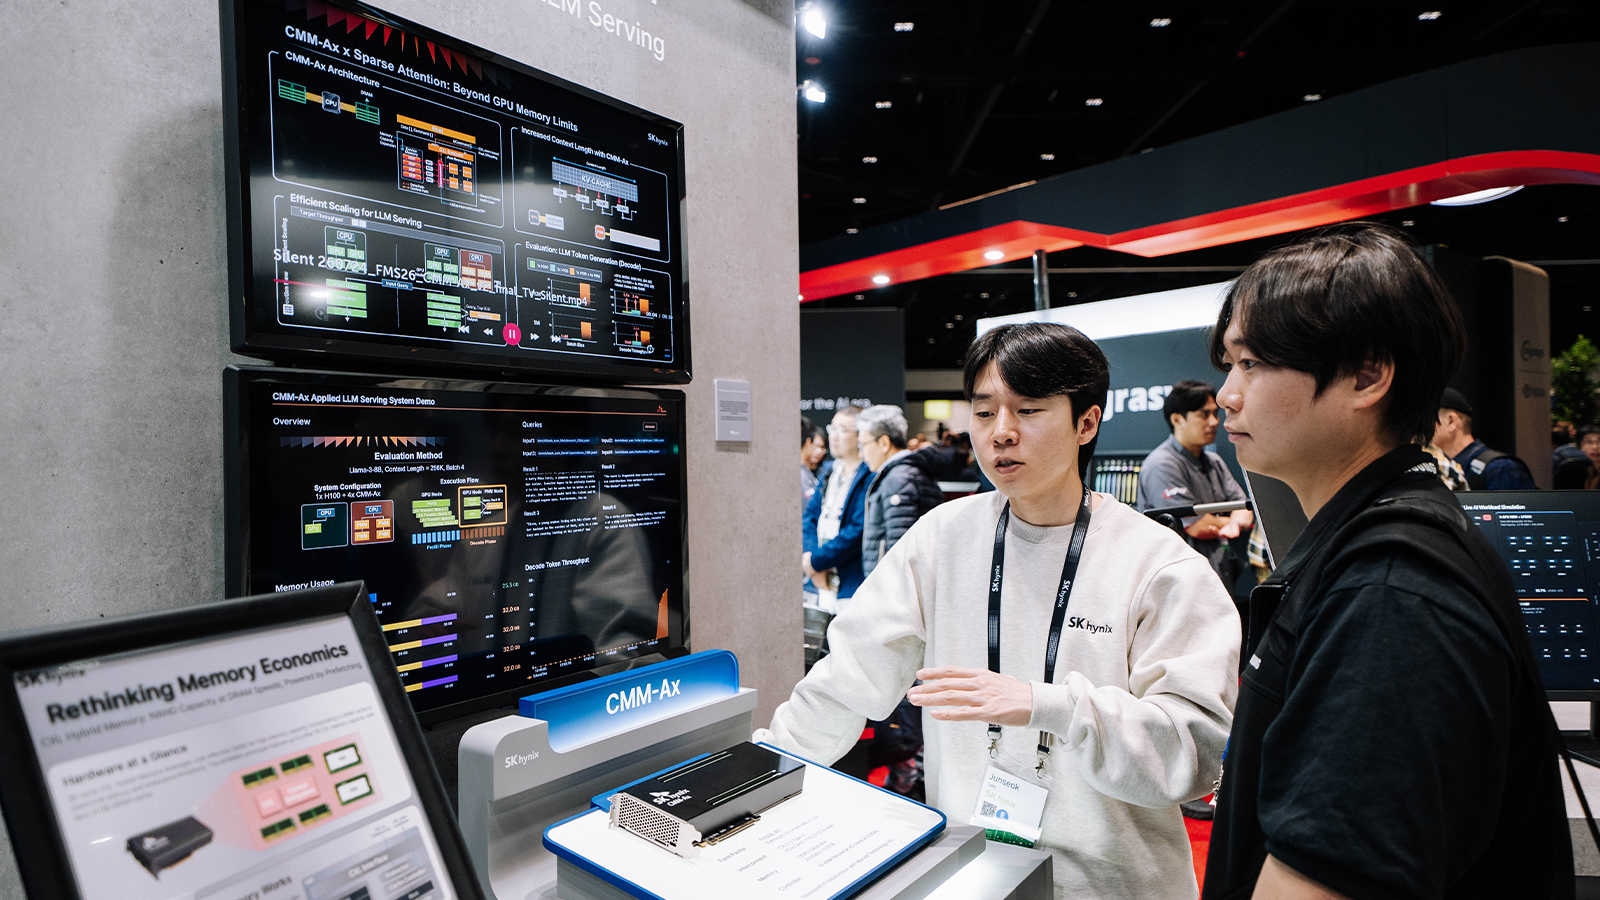
▲ Efficient Long Context LLM Serving 기술 시연 모습
CMM-Ax는 메모리에 연산 기능을 결합한 차세대 메모리 설루션이다. 데이터를 옮기지 않고 메모리 내부에서 직접 연산을 수행해, 데이터센터의 전력과 비용 부담을 줄일 수 있다. SK하이닉스는 이번 전시에서 차세대 AI 추론 시스템 ‘Efficient Long Context* LLM* Serving’ 데모를 통해, CMM-Ax로 기존 GPU 기반 시스템에서 처리하기 어려웠던 긴 문맥을 효율적으로 가속할 수 있음을 보여줬다. 이러한 성과를 담은 연구는 컴퓨터 아키텍처 분야 최고 권위 학회인 ‘MICRO 2026’에 채택되며 기술적 우수성을 공식적으로 인정받기도 했다.
* LLM(Large Language Model): 빅데이터를 학습해 인간처럼 자연스러운 문장을 생성하고 이해하는 인공지능 모델. 매개변수(Parameter)의 규모를 대폭 키워 복잡한 문맥 파악, 추론, 번역 등 고도의 언어 처리 능력을 갖춤
HBM에서 HBF까지, 제품 포트폴리오 공유… 메모리 기술의 현재와 미래, 한자리서 확인
메모리 섹션은 현재 메모리 시장을 이끌고 있는 SK하이닉스의 주력 제품을 만나볼 수 있게 구성됐다. 가장 왼쪽 제품 포트폴리오 전시공간에서는 eSSD와 서버 D램을 아우르는 AI 인프라향 제품 라인업이 전시됐다.
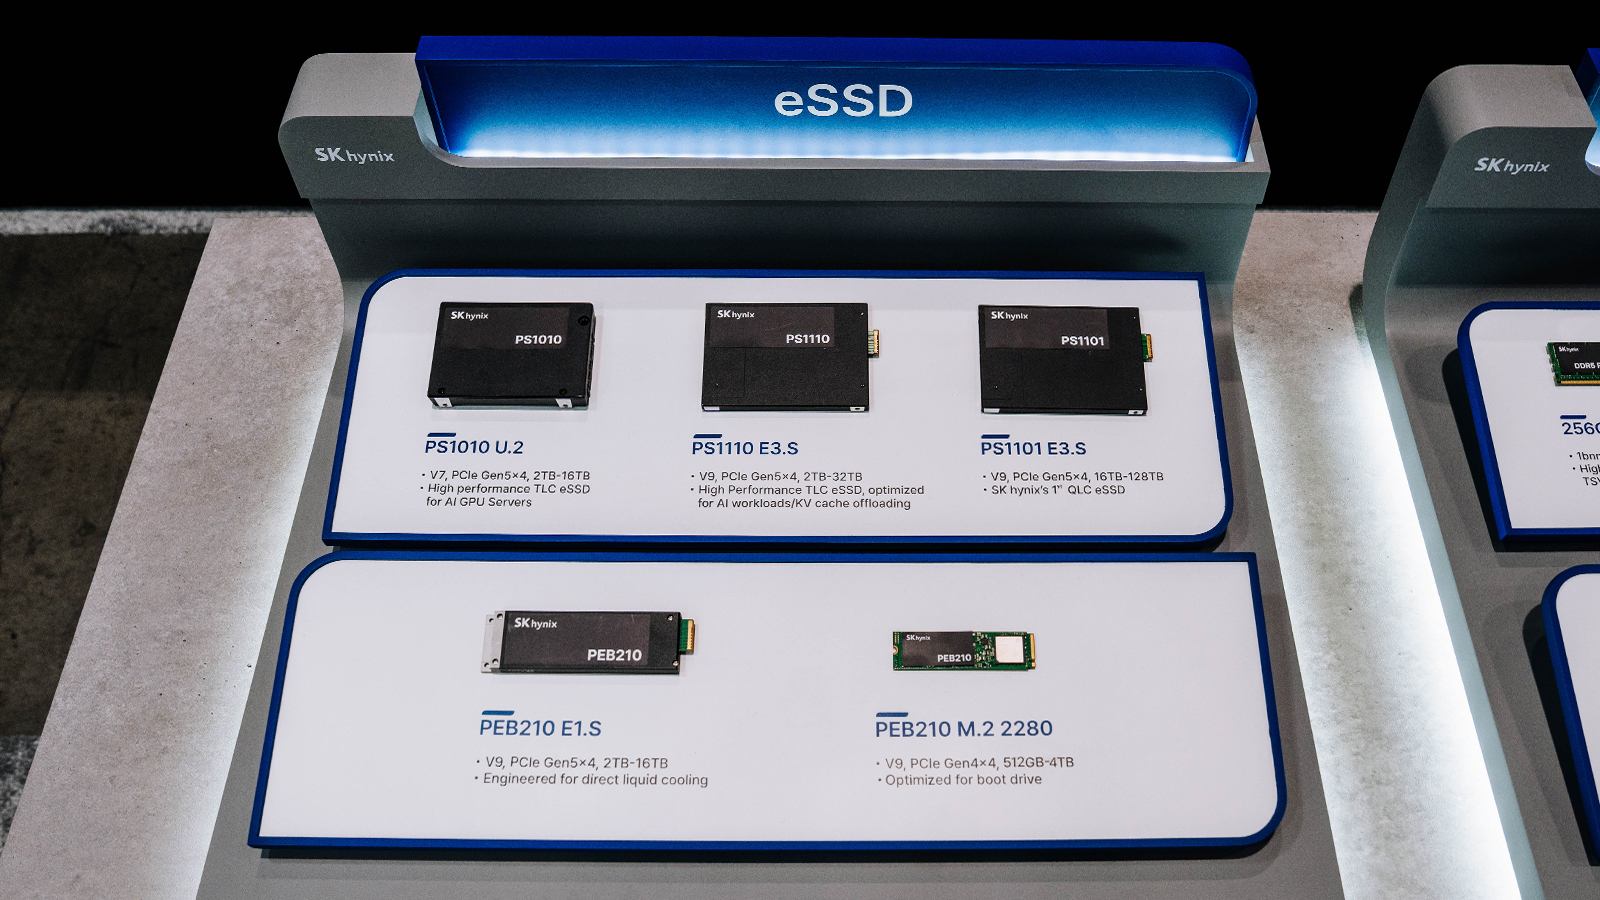
eSSD로는 폼팩터(Form Factor)별로 고성능 ‘PS1010 U.2’ 뿐만 아니라 순차적으로 개발 중인 고성능 ‘PS1110 E3.S’와 고용량 ‘PS1101 E3.S’를 비롯해 액체냉각(Direct Liquid Cooling, DLC)을 지원해 데이터센터용 eSSD로 주목받는 ‘PEB210 E1.S’와 ‘PEB210 M.2 2280’에 이르기까지 고객의 다양한 요구에 맞춰 각기 다른 활용도를 가진 제품 라인업이 소개됐다.
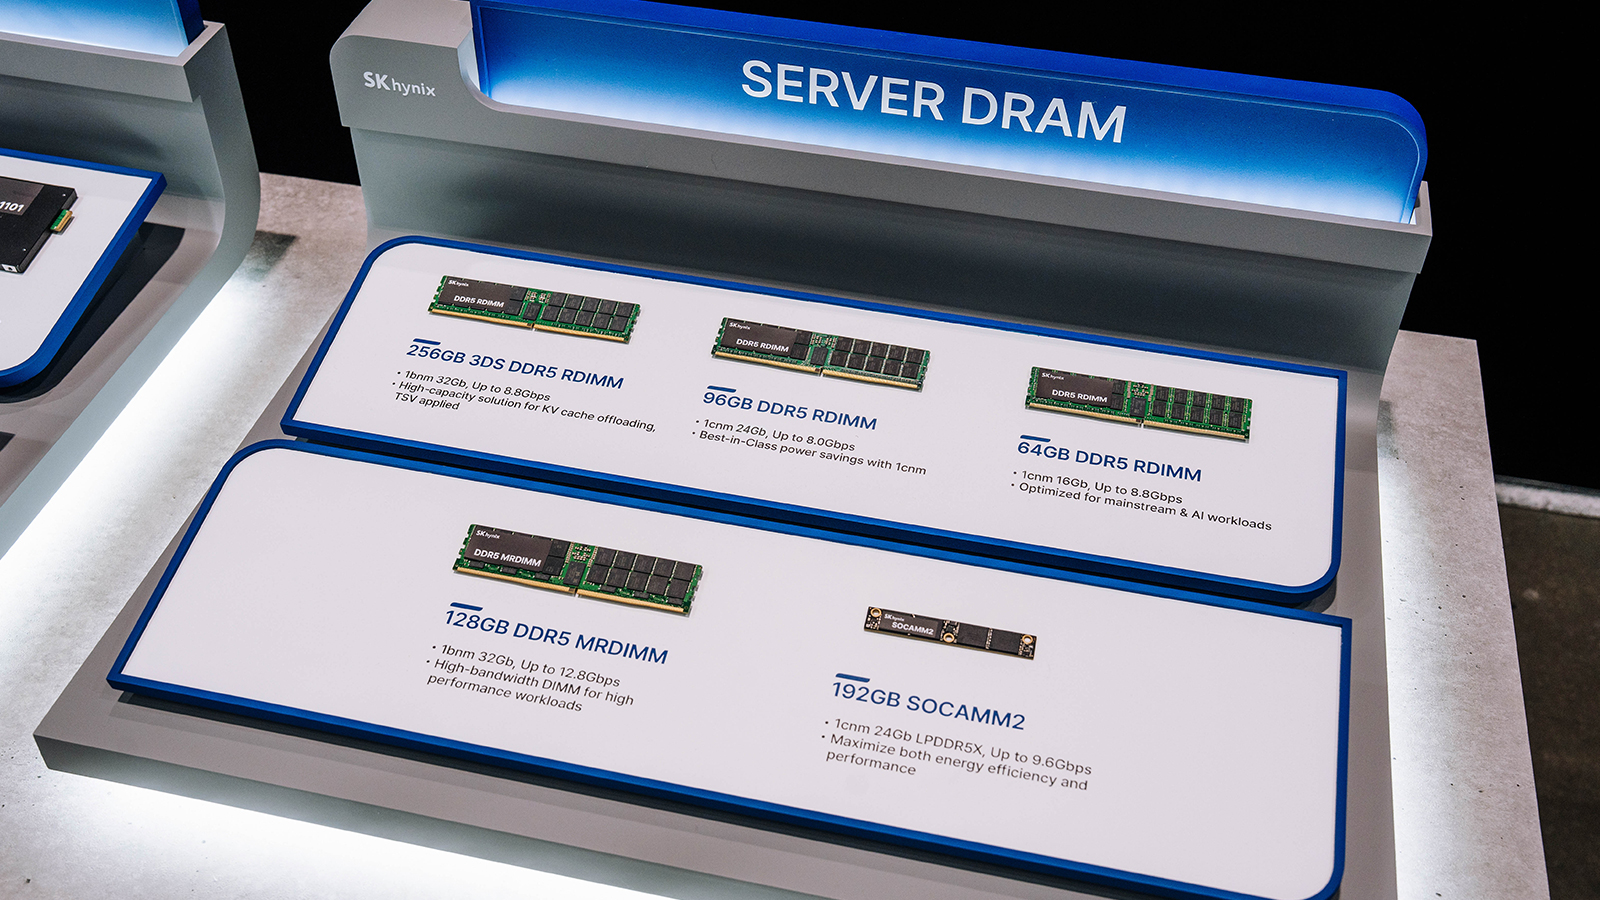
서버 D램으로는 AI 워크로드에 맞춰 업계 최대 용량을 구현한 ‘256GB 3DS* RDIMM*’을 필두로 96GB, 64GB 등 다양한 용량의 DDR5 RDIMM 라인업이 소개됐고, 128GB DDR5 MRDIMM*과 함께 새로운 폼팩터로 전력 효율과 공간 효율을 높인 ‘192GB SOCAMM*2’도 함께 전시됐다.
* RDIMM(Registered Dual In-line Memory Module): 여러 개의 D램이 결합된 서버용 모듈
* MRDIMM(Multiplexed Rank Dual In-line Memory Module): 모듈의 기본 동작 단위인 랭크(Rank) 2개가 동시 작동되어 속도가 대폭 향상된 제품
* SOCAMM(Small Outline Compression Attached Memory Module): 저전력 D램 기반의 AI 서버 특화 메모리 모듈
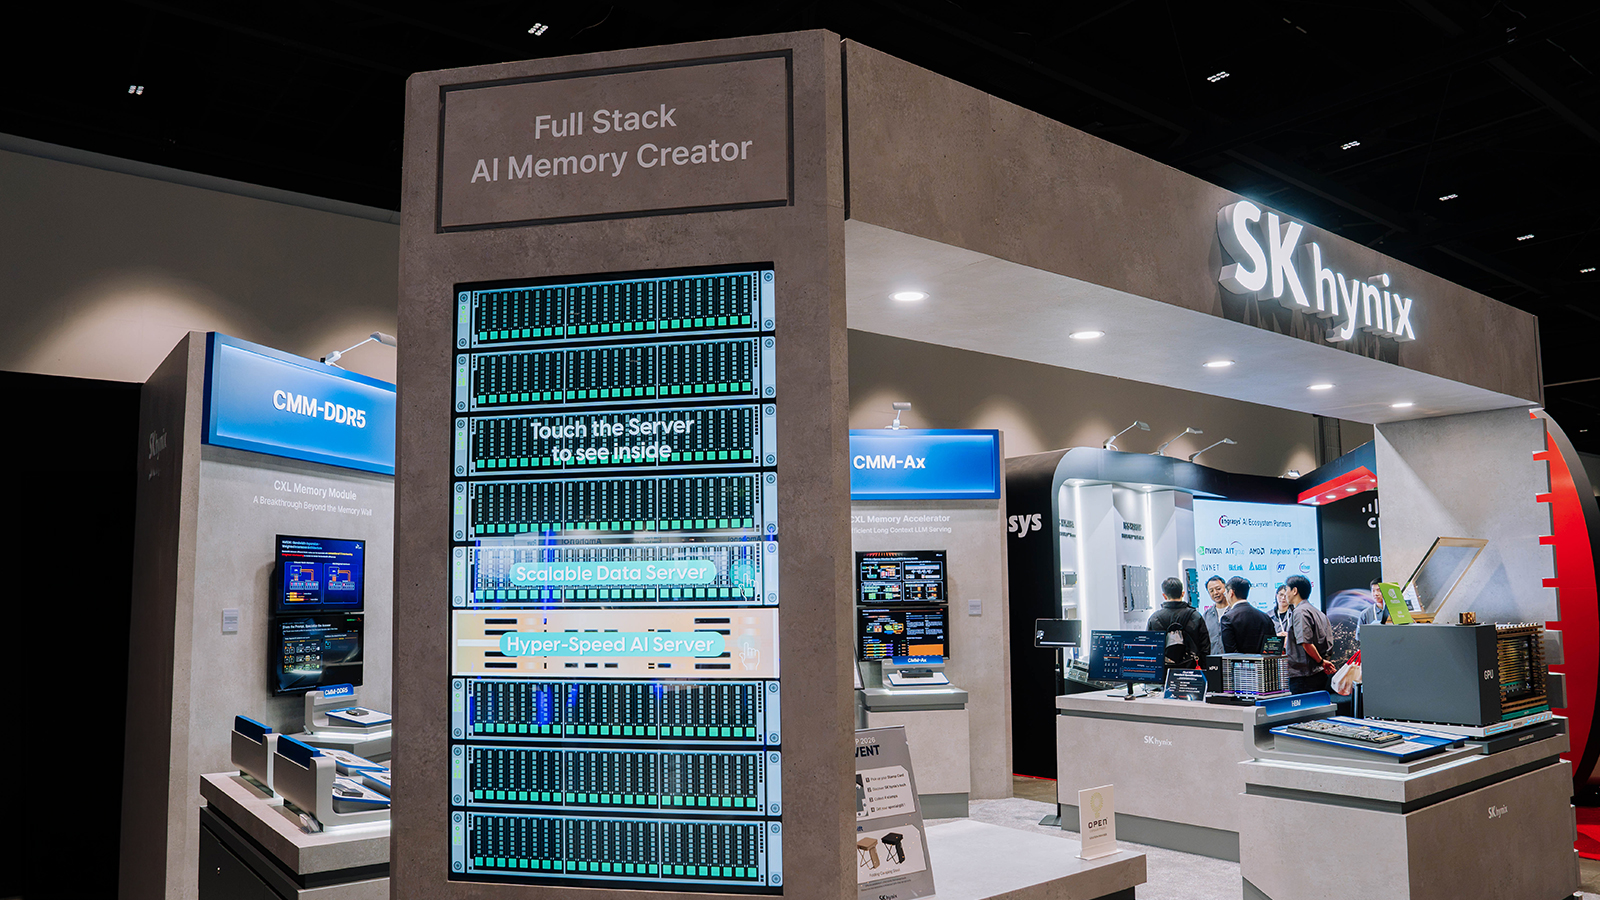
▲ 제품 정보를 확인할 수 있는 터치스크린
이와 함께 실제 서버를 본뜬 터치스크린 모형도 함께 배치해, 관람객이 제품을 직접 터치해 상세한 제품 정보를 확인할 수 있도록 했다.
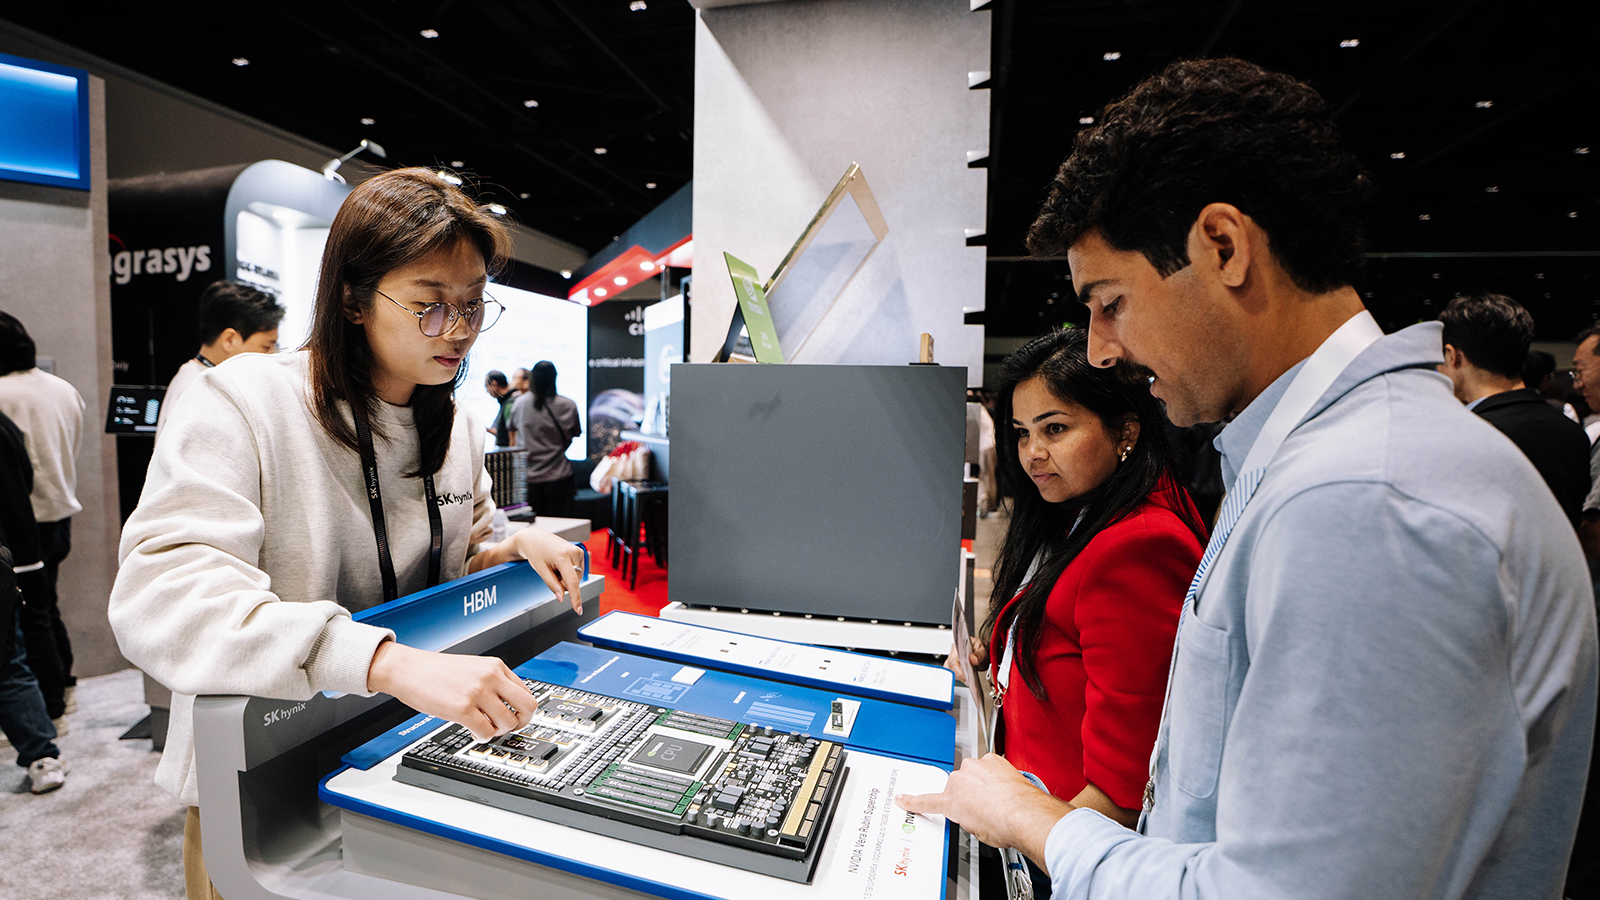
▲ 엔비디아의 베라 루빈 모형에 SK하이닉스의 HBM4 제품을 체결 중인 관람객
가운데 HBM* 전시공간에서는 SK하이닉스의 HBM 기술 리더십과 엔비디아(NVIDIA)와의 견고한 파트너십을 한눈에 확인할 수 있도록 했다. 전시대 왼편에는 엔비디아의 베라 루빈 슈퍼칩 모형을 배치해 양사의 파트너십을 확인할 수 있게 하는 한편, 관람객이 서버 모형에 HBM4와 SOCAMM2를 직접 탑재해볼 수 있게 했다. 오른편에는 실제 HBM을 100만 배 확대한 모형을 두고, 함께 비치된 모니터로 HBM 구현의 핵심 기술인 TSV*와 어드밴스드 MR-MUF* 기술을 소개하는 영상을 상영했다. 두 모형 사이에는 HBM4E, HBM4, HBM3 실물 제품을 배치해, 관람객이 세대별 HBM 제품의 변천사를 직접 살펴볼 수 있게 했다.
* TSV(Through Silicon Via): 실리콘 기판을 수직으로 관통하는 전극을 통해 칩을 수직으로 연결하는 기술
* 어드밴스드(Advanced) MR-MUF: 기존 칩 두께 대비 40% 얇은 칩을 휘어짐 없이 적층할 수 있는 칩 제어 기술(Warpage Control)이 적용되고, 방열 특성까지 향상된 차세대 MR-MUF 기술
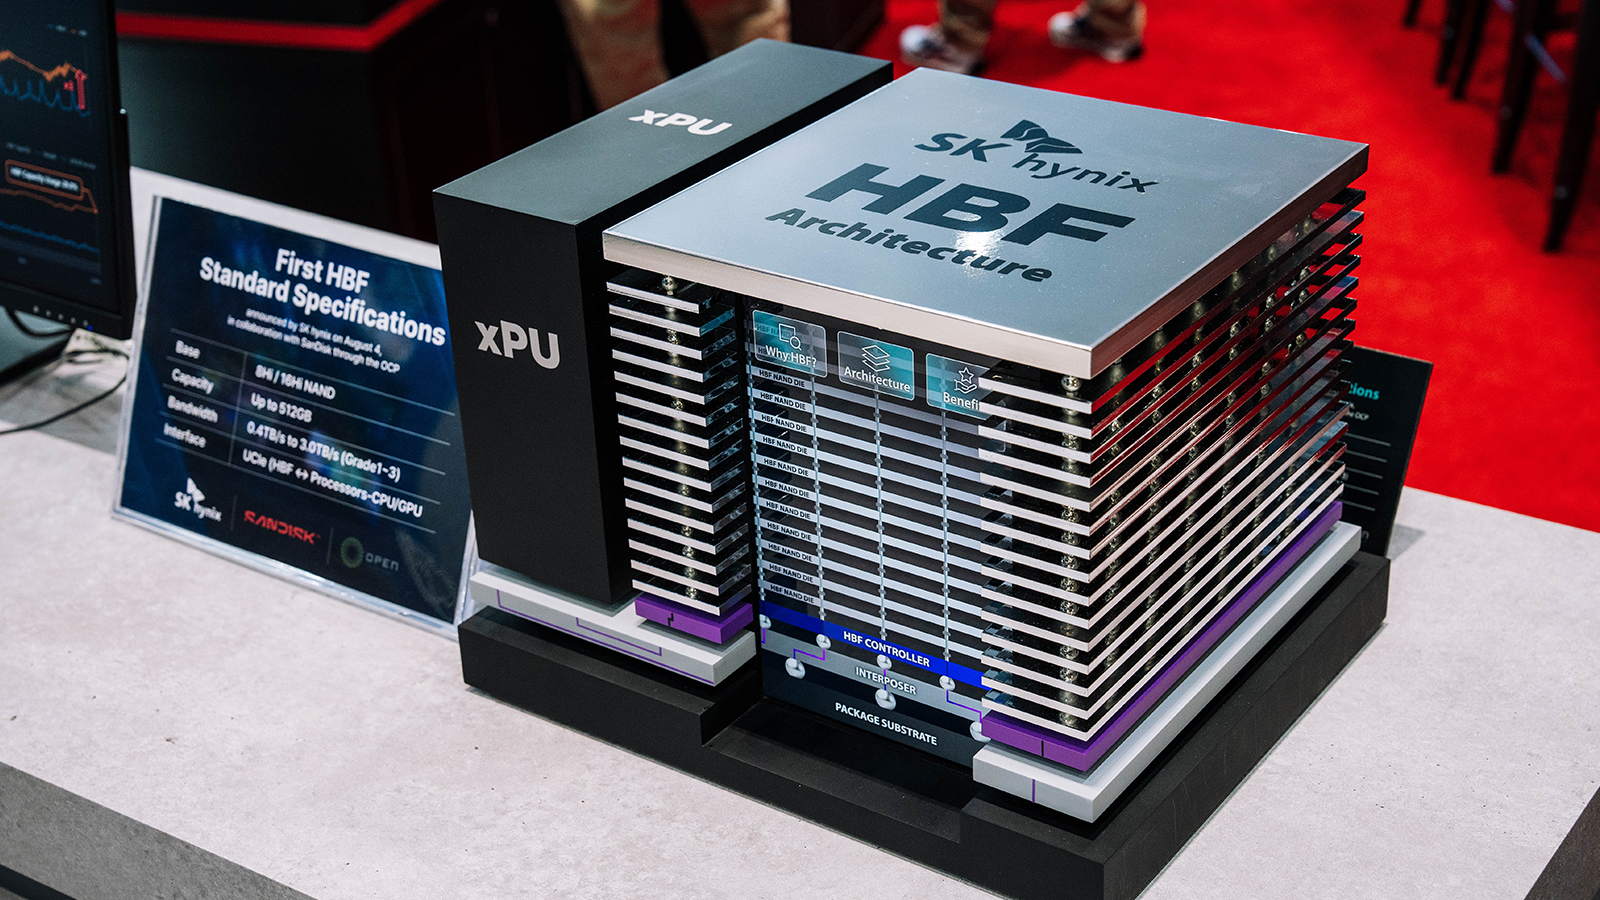
▲ HBF 구조를 확인할 수 있는 모형
HBF(High Bandwidth Flash)는 HBM처럼 TSV 기술을 적용해 기존 스토리지의 대용량 특성에 고대역폭까지 함께 구현한 차세대 낸드 설루션으로, 추론 중심의 에이전틱 AI 시대가 열리면서 급증하고 있는 AI의 데이터 사용량을 효율적으로 처리할 핵심 기술로 주목받고 있다. 전시대 왼편에는 HBF의 구조를 확인할 수 있는 모형이 배치됐고, 그 오른편으로 상세 사양을 소개하는 배너가 자리했다. 모니터와 태블릿을 통해서는 HBF의 주요 특징과 AI 추론 서비스 환경에 따른 HBM과 HBF의 강점을 영상과 내부 시뮬레이션 기반의 성능 그래프로 소개했다. 빠른 응답 속도가 중요한 환경에서는 HBM의 고속 처리 성능을, 다수의 사용자에게 서비스를 제공하기 위해 대용량 메모리가 필요한 환경에서는 HBF의 대용량 특성을 활용할 수 있다는 점을 제시했다.
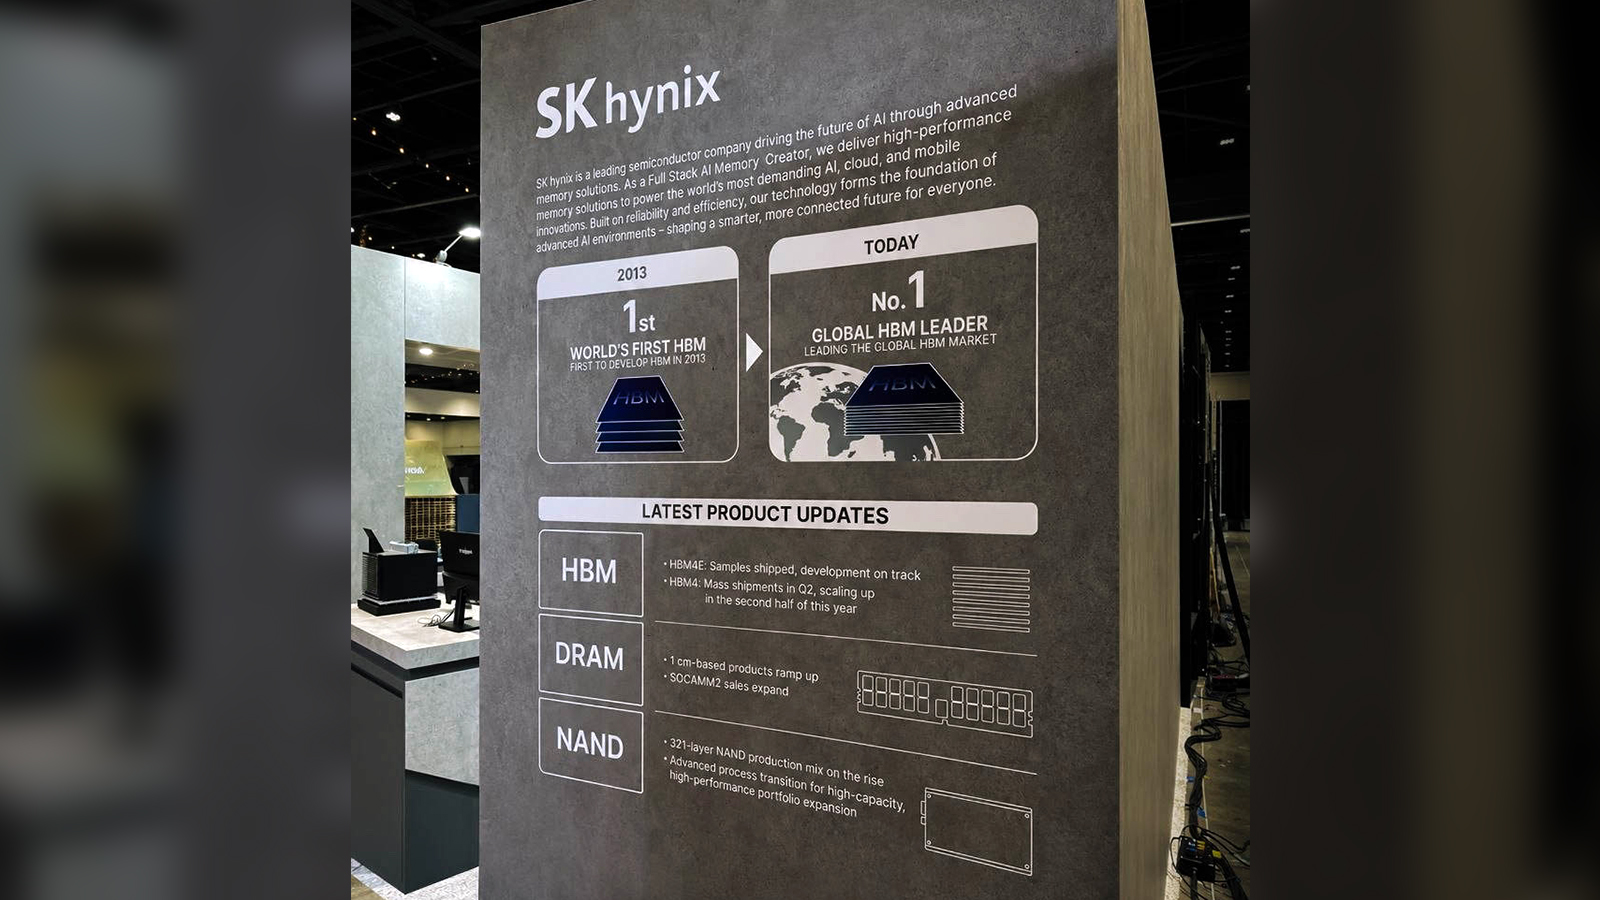
▲ 부스 외곽 벽에 위치한 SK하이닉스의 비전을 담은 그래픽 전시
한편, 부스 오른쪽 벽면에는 메모리 계층 전반에서 최적화된 설루션을 제공한다는 회사의 비전을 담은 그래픽이 전시됐다. 2013년 세계 최초로 HBM을 개발한 이후 지금의 기술 리더십을 갖추기까지의 여정과 함께, HBM, D램, 낸드 각 분야의 최신 제품 및 기술 개발 현황도 함께 소개됐다.
“메모리 중심 차세대 AI 랙 시스템으로 기술 한계 뛰어넘겠다”
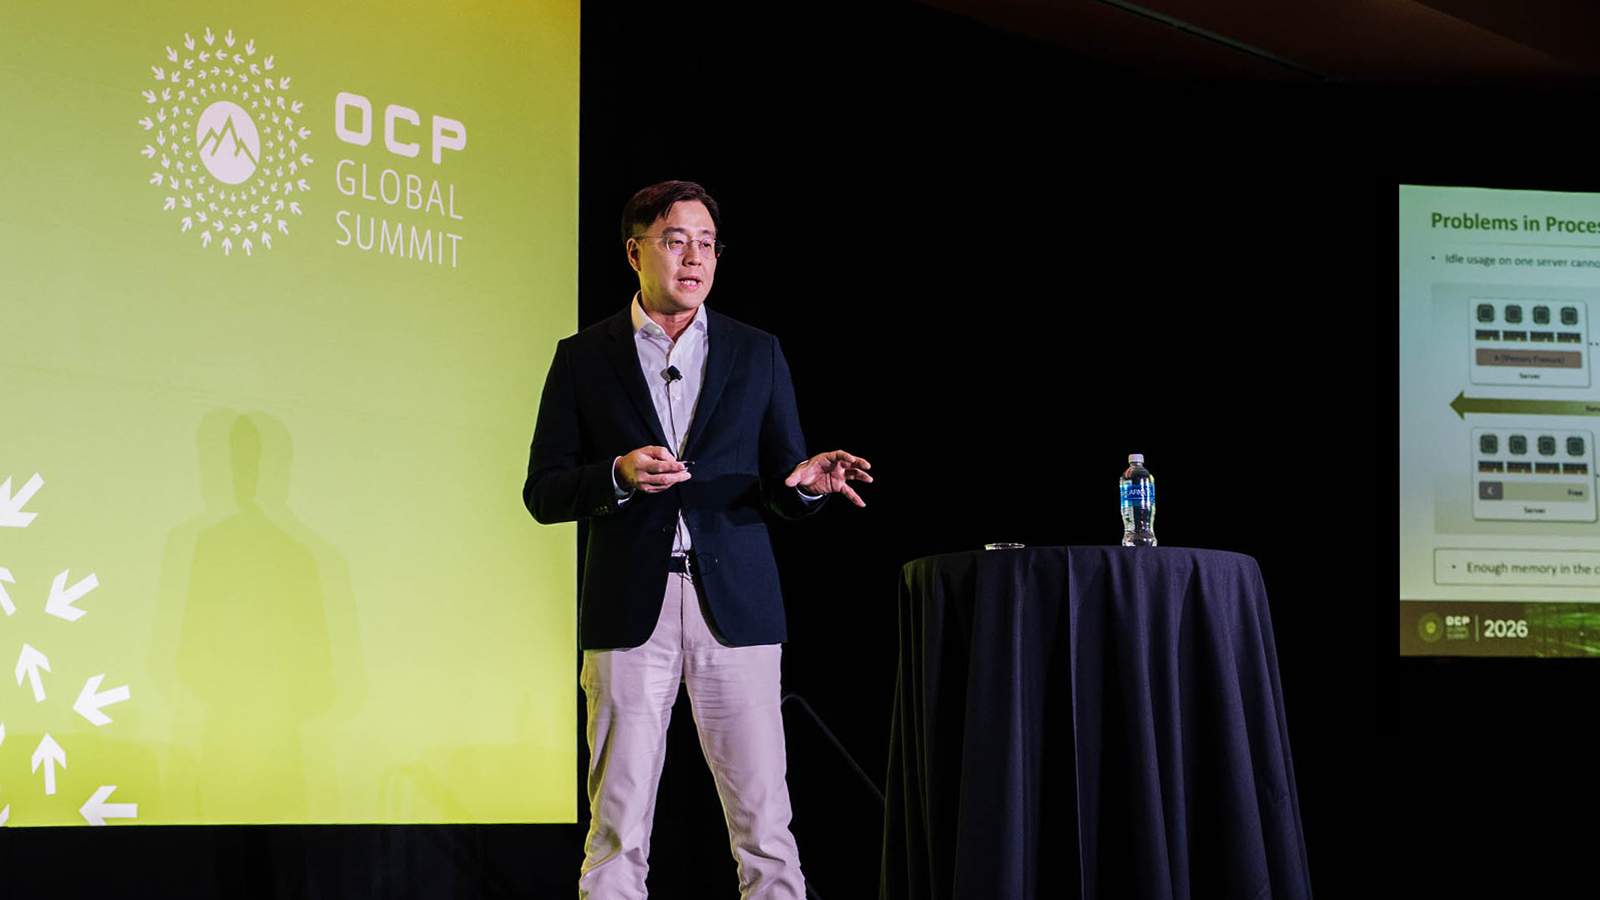
▲ 발표 중인 김호식 부사장(Memory Systems Research 담당)
전시와 함께 발표 세션에서도 메모리 중심 서버 시스템에 대한 기대감을 높였다.
먼저 첫째 날 오후 진행된 ‘Executive’ 세션에서는 김호식 부사장(Memory Systems Research 담당)이 연사로 나서 ‘메모리 중심 AI 랙 시스템(Introduction to Memory-centric AI Rack Systems (MARS))’을 주제로 발표했다.
김 부사장은 먼저 생성형 AI와 하이퍼스케일 데이터센터가 빠르게 성장하면서 기존 CPU · GPU 중심 아키텍처가 ‘메모리 월(Memory Wall)’로 불리는 병목과 급증하는 전력 소비에 직면했다고 짚은 뒤, 그 해법으로 ‘메모리 중심 AI 랙 시스템’을 제시했다.
그는 “이 시스템은 차세대 CXL 기술로 CPU와 GPU를 연결하는 랙 단위 메모리 풀링과 동적 제로카피 데이터 공유를 구현한 시스템”이라며 “고부하 워크로드의 데이터 이동 속도를 크게 끌어올릴 수 있는 구조를 갖추고 있다”고 설명했다.
이어 “이를 활용해 협업형 에이전틱 AI의 KV 캐시 재사용 효율을 높이고, Personal 에이전틱 AI 서비스의 멀티모달 옴니 모델의 응답 속도를 가속화하며, 대규모 GNN* 학습에서 나타나는 불규칙한 메모리 접근 문제를 해결할 수 있다”고 덧붙였다.
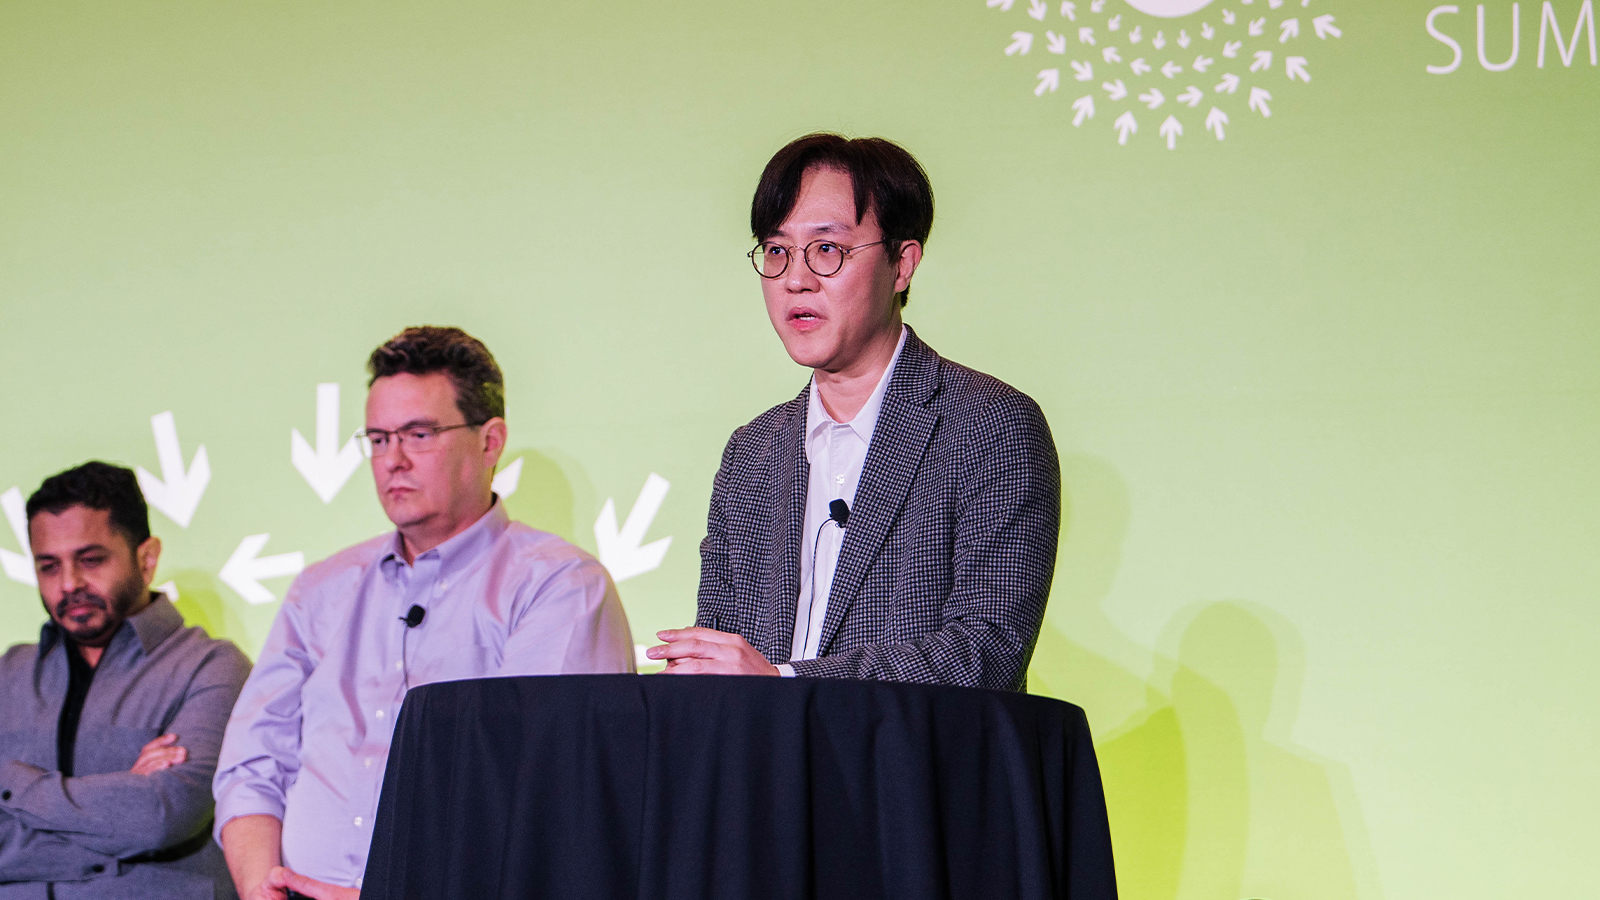
▲ (오른쪽) 패널 토의에 참여 중인 주영표 부사장(System Architecture 담당)
또, 셋째 날 오후 진행된 패널 토의에도 주영표 부사장(System Architecture 담당)이 참가했다. ‘PIM/PNM에 대한 업체 간 SW framework 및 API의 통합’을 주제로 진행된 이번 패널 토의에서, 여러 업체들이 경쟁과 협력 관계로 맞물려 있는 생태계 내에서 고객과 제품을 이어주는 SW framework의 중요성에 대해 짚었고, 이에 대한 표준화 필요성에 대해서도 논의를 진행했다.
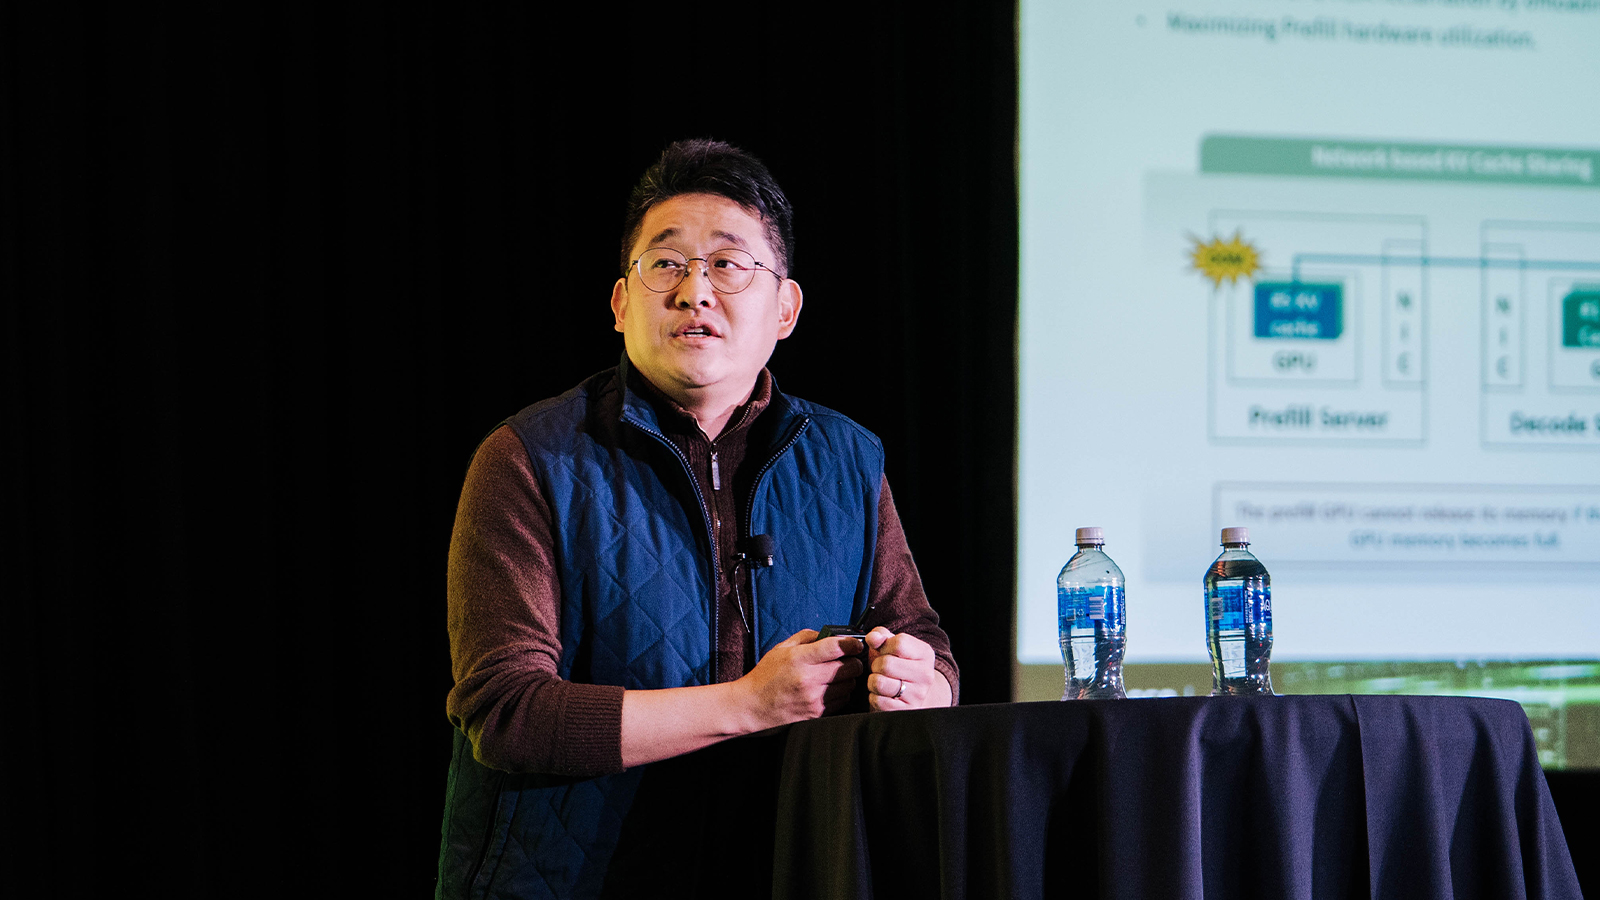
같은 날 함께 진행된 ‘Breakout’ 세션에서는 개발 현장의 실무진이 발표에 나서, 주요 메모리 기술의 필요성과 개발 배경, 실제 개발 여정과 현황을 상세히 소개했다. 먼저 김종률 팀장(AI System Infra)이 Agentic AI 서비스 성능을 높이는 공유 메모리 기반 토큰 공유(Token Sharing)와 KV 캐시 공유(KV Cache Sharing) 기술을 발표했다. 토큰 공유를 통한 CPU 기반 토큰화(Tokenization) 속도 향상과 KV 캐시 공유를 통한 AI 모델의 응답 속도 및 컴퓨팅 자원 효율성 향상을 소개했다. 더불어 토큰화 연산과 KV 캐시 데이터의 중요도를 실시간으로 분석하는 연산을 공유 메모리로 오프로딩(offloading)하여 Agentic AI 서비스 성능을 높이는 가능성을 제시했다.
민영훈 TL(AI System Infra)은 펜실베이니아 주립대학교 맹기완 교수와 함께 연산 기능을 탑재한 메모리를 이용하여 차등 개인정보보호를 적용한 AI 학습을 효율화하는 시스템 아키텍처(A System Architecture using Computational Memory for Differentially Private Training)를 주제로, 개인정보 보호를 위한 학습 과정의 추가 연산 부담과 데이터 이동을 줄여, 학습 속도와 에너지 효율을 높이는 핵심 기술을 소개했다.
마지막으로 이주희 TL(AI Platform SW)이 ‘성능 계층으로서의 스토리지를 활용한 LLM 서빙(Storage as a Performance Tier for LLM Serving)’을 주제로 발표를 진행했다.
SK하이닉스는 “이번 OCP 글로벌 서밋에서는 차세대 메모리 설루션이 실제 시스템에서 어떻게 작동하는지 직접 보여줄 수 있어 그 의미가 컸다”며 “앞으로도 메모리를 중심으로 AI 기술이 계속 발전해 나갈 수 있도록 기술 혁신을 지속해 나가겠다”고 말했다.