[AI Ecosystem]은 AI를 하나의 모델이나 알고리즘이 아니라, 소프트웨어, 데이터센터 인프라, 반도체와 메모리 기술이 맞물려 작동하는 하나의 생태계로 바라보는 시리즈다.
AI 워크로드가 추론과 에이전틱 AI 중심으로 고도화될수록 성능 경쟁의 기준도 달라지고 있다. 이제는 연산 능력뿐 아니라 데이터를 어디에 저장하고, 얼마나 빠르게 이동시키며, 얼마나 효율적으로 처리할 것인가가 AI 시스템의 성능과 비용을 좌우한다.
이번 시리즈는 이러한 AI 생태계의 변화를 따라가며 메모리 반도체가 왜 AI 시대의 핵심 기반으로 부상하고 있는지를 살펴보고, SK하이닉스가 함께 만들어갈 AI 메모리 생태계의 방향성을 조망한다.
① AI 연산의 패러다임 시프트
② 병목의 실체, 연산이 아닌 데이터
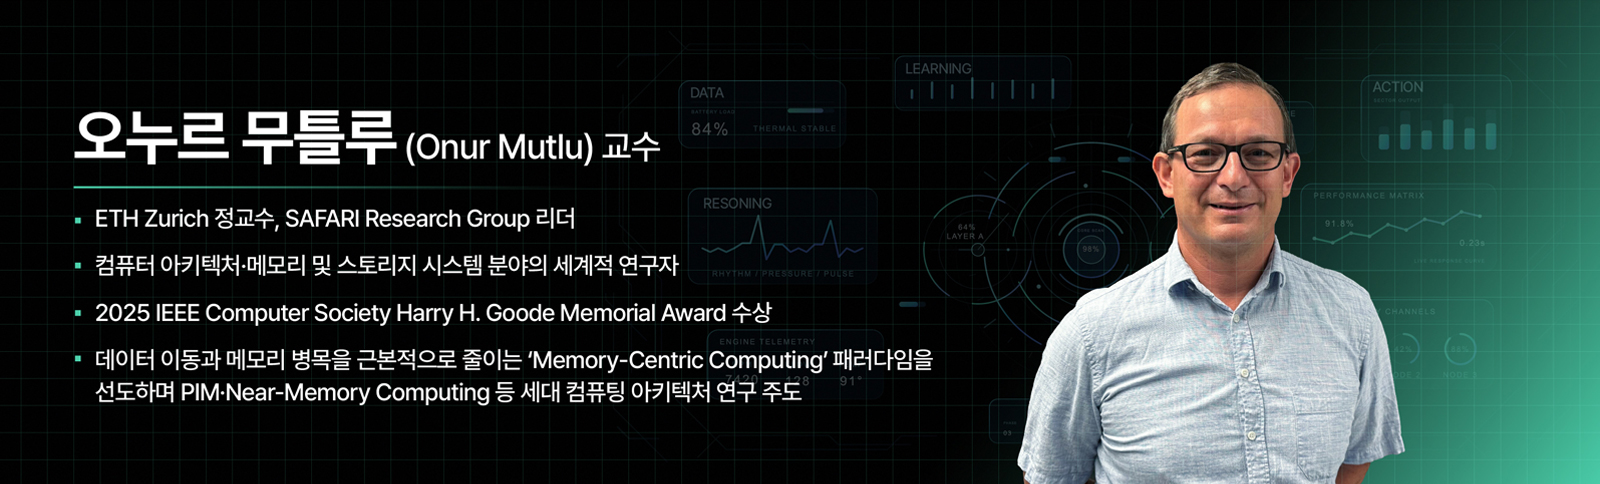
③ 인프라 재설계, 구조가 성능을 결정한다 – 취리히 연방공과대학교(ETH Zurich) Onur Mutlu 교수
④ 반도체 패러다임의 이동, 메모리 중심으로
⑤ AI의 완성, 실체적 지능과 메모리
더 빠른 부품에서 덜 움직이는 시스템으로
ChatGPT, 제미나이나 클로드와 같은 대규모 언어모델 서비스가 질문 하나에 답하려면 모델은 방대한 가중치와 이전 문맥, 중간 결과를 반복해서 참조해야 한다. 답변이 길어지고 추론 단계가 늘어날수록 읽어야 할 데이터도 증가한다. AI 시스템의 핵심 과제 중 하나는 방대한 데이터를 얼마나 빠르고 안정적으로 연산 장치에 공급하느냐에 있다.
AI 산업의 초점은 모델을 만드는 단계에서 대규모 서비스를 운영하는 단계로 옮겨가고 있다. 사전 학습은 막대한 비용이 한 번에 들어가는 작업이지만, 추론은 사용자가 질문할 때마다 반복된다. 생성형 AI 서비스, 기업용 코파일럿, 에이전틱 AI(Agentic AI)가 확산될수록 요청 수는 늘고, 각 요청이 유지해야 하는 문맥도 길어진다. 이제 AI 인프라 경쟁은 더 빠른 GPU/NPU/TPU들과 더 큰 클러스터를 확보하는 데서 나아가, 연산 장치 · 메모리 · 스토리지 · 네트워크를 하나의 시스템으로 공동 설계하고, 그 안에서 불필요한 데이터 이동을 얼마나 줄이느냐가 경쟁의 기준이 된다. 더 정확히 말하면, 시스템 구성 요소 사이에서 데이터 이동 자체를 얼마나 최소화할 수 있느냐가 핵심이다.
프로세서 중심 구조가 만든 데이터 이동 비용
오늘날의 컴퓨팅 시스템은 AI와 머신러닝, 유전체 분석, 대규모 데이터 분석처럼 방대한 데이터를 처리할 수 있을 만큼 발전했다. 하지만 그 기본 구조는 여전히 프로세서 중심이다. 데이터는 처리 전후에 센서와 스토리지, 메모리, 캐시를 거쳐 연산 장치까지 이동하고 다시 돌아오는 과정을 지속적으로 반복해야 한다.
이 구조는 오랫동안 범용 컴퓨팅의 성능을 높이는 데 효과적으로 작동했다. 그러나 AI 워크로드의 데이터 규모와 접근 빈도가 급증하면서 데이터 이동 비용이 시스템 효율을 제약하는 요인으로 부상했다. 모델은 방대한 가중치와 중간 결과를 계속 참조하고, 추론 과정에서는 이전 문맥과 새로 생성되는 토큰을 반복해서 읽어야 한다. 오가는 데이터가 많고 이동 경로가 길어질수록 지연시간과 전력 소모, 하드웨어 비용은 커진다.
시스템 설계자들은 이 부담을 줄이기 위해 캐시 계층*, 데이터를 미리 가져오는 프리페칭, 여러 작업을 병렬로 실행하는 멀티스레딩, 비순차 실행* 같은 최적화 기법을 발전시켜 왔다. 이런 기법은 연산 장치의 대기 시간을 일부 줄였지만, 데이터 이동 병목 자체를 없애지는 못했다. 대신 시스템 구조는 더 복잡해졌고, 에너지 비효율과 하드웨어 비용도 커졌다. 결국 데이터 이동 문제를 해결했다기보다, 그로 인한 지연을 여러 구조적 장치로 완화해 온 셈이다.
* 비순차 실행(Out-Of-Order Execution): 프로그램에 적힌 순서와 다르더라도, 먼저 처리할 수 있는 명령을 앞당겨 실행해 연산 장치의 대기 시간을 줄이는 방식
현대 시스템에서는 연산 자체보다 메모리 접근과 데이터 이동에 더 큰 비용이 든다. D램에서 데이터를 한 번 읽어오는 데 드는 에너지는 단순 산술 연산보다 150배에서 2,000배까지 클 수 있다. 실제 TPU(Tensor Processing Unit) 시스템에서 신경망 모델을 실행한 연구에서도 이 차이는 확인됐다*. 대형 머신러닝 모델의 경우 시스템 에너지의 90% 이상이 연산이 아니라 메모리 접근과 데이터 이동에 쓰이는 것으로 나타났다*.
* Onur Mutlu et al., “A Modern Primer on Processing in Memory,” in Emerging Computing: From Devices to Systems – Looking Beyond Moore and Von Neumann, Springer, 2022; updated 2025
이 차이는 대규모 언어모델에서 더 커진다. LLM은 매 토큰을 생성할 때마다 이전 문맥을 참조하고, KV 캐시*와 어텐션 연산을 통해 방대한 중간 데이터를 다룬다. 모델이 오래 추론하고 긴 문맥을 유지할수록 메모리 용량과 대역폭* 요구도 급격하게 상승한다. 그만큼 메모리 병목도 커진다. 연산 장치가 아무리 빨라도 데이터가 제때 도착하지 않으면 시스템 효율은 떨어진다.
AI 워크로드가 커질수록 GPU 등 AI 가속기는 더 많은 데이터를 더 빠르게 받아야 한다. HBM은 GPU/NPU/TPU 가까이에 배치돼 대량의 데이터를 고속으로 공급하고, 연산 장치가 데이터를 기다리는 시간을 줄인다. 다만 HBM의 성능을 충분히 끌어내려면 GPU/NPU/TPU, HBM뿐만 아니라 스토리지, 네트워크, 인터커넥트*까지 이어지는 데이터 경로 전체를 함께 설계해야 한다.
* 메모리 대역폭(Memory bandwidth): 일정 시간 동안 전송할 수 있는 데이터의 양. 메모리 대역폭이 높을수록 연산 장치가 한 번에 더 많은 데이터를 받아 처리할 수 있다.
* 인터커넥트(Interconnect): 프로세서, 메모리, 가속기, 스토리지 등 시스템 구성 요소를 연결하는 통신 경로. AI 인프라에서는 데이터 이동 속도와 효율에 직접적인 영향을 미친다.
부품의 속도보다 중요한 시스템 구조
시스템의 기본 전제도 달라져야 한다. 프로세서 중심 구조는 데이터를 연산 장치로 가져와 처리하는 방식에 가깝다. 데이터 규모가 커지고 접근 빈도가 높아질수록, 모든 데이터를 중앙 연산 장치로 보내는 구조는 빠르게 한계에 부딪힌다. 이제는 데이터를 어디에 두고 어떤 경로로 처리할지 다시 설계해야 한다.
이런 문제를 해결하기 위해 등장한 개념이 메모리 중심 컴퓨팅*이다. 메모리 중심 컴퓨팅은 데이터의 위치와 이동 비용을 시스템 설계의 기준으로 삼고, 메모리 배치와 연산 구조를 함께 최적화하는
접근이다*. 일부 데이터는 GPU/NPU/TPU 같은 AI 가속기 옆의 HBM에 두고, 일부는 공유 메모리 풀*에서 관리하며, 특정 연산은 메모리 근처에서 먼저 수행하는 식이다. 어떤 방식을 택할지는 모델 구조, 문맥 길이, 사용자 요청 수, 네트워크 구성에 따라 달라진다.
이런 메모리 중심 시스템은 학계뿐 아니라 산업계에서도 설계 · 평가가 진행되고 있다. 핵심은 분명하다. 데이터를 더 빠르게 많이 옮기는 것이 아니라, 가능한 한 덜 옮기도록 시스템을 짜는 것이다.
* Onur Mutlu et al., Memory-Centric Computing: Solving Computing’s Memory Problem, 17th IEEE International Memory Workshop(IMW) (2025)
* 메모리 풀(Memory Pool): 여러 장치가 접근할 수 있도록 묶어둔 공유 메모리 자원. 필요한 장치가 필요한 만큼 메모리를 활용할 수 있어 시스템 자원 활용도를 높일 수 있다.
고속 인터커넥트: 메모리 확장과 GPU 연결의 두 축
프로세서와 메모리, 가속기는 기존에도 다양한 인터페이스를 통해 연결돼 있었다. 그러나 AI 워크로드가 처리하는 데이터의 규모가 커지면서 기존 연결 구조만으로는 필요한 통신 대역폭과 메모리 활용 효율을 확보하기 어려워졌다. 이때 고속 인터커넥트는 장치 사이의 통로를 넓히고, 워크로드에 따라 메모리와 연산 장치를 더 유연하게 묶는다. CXL*과 NVLink/NVSwitch*는 서로 다른 영역에서 이런 변화를 이끄는 대표적인 기술이다. 이와 함께 여러 장치를 더 긴밀하게 통합하려는 학계 연구도 이어지고 있다.
* NVLink/NVSwitch: NVIDIA가 개발한 고속 인터커넥트 기술. NVLink는 GPU 간 또는 GPU와 다른 장치 간 고대역폭 연결을 제공하고, NVSwitch는 여러 GPU가 더 큰 규모에서 고속으로 통신할 수 있도록 연결망을 확장한다. 대규모 AI 클러스터에서 GPU 간 데이터 병목을 줄이는 데 활용된다.
CXL은 메모리 확장과 공유를 가능하게 하는 대표적인 인터커넥트다. 전통적인 서버 구조에서는 메모리가 특정 CPU나 GPU/NPU/TPU 같은 AI 가속기에 붙어 있는 전용 자원에 가까웠다. 어느 장치에는 메모리가 남고 다른 장치에는 부족해도 이를 유연하게 나눠 쓰기 어려웠다. CXL은 프로세서와 가속기, 메모리 장치 사이의 연결을 확장해 메모리 용량을 유연하게 늘리고 여러 장치가 메모리를 공유하거나 풀링할 수 있는 기반을 제공한다. 또한 일부 연산을 메모리 가까이에 있는 장치나 컨트롤러로 넘기고, CXL 장치끼리도 유연하게 통신할 수 있는 구조를 만든다.
NVLink와 NVSwitch는 GPU 클러스터 내부의 고대역폭 연결을 담당한다. 대규모 AI 모델이 여러 GPU와 노드에 걸쳐 실행될 때 모델 파라미터, 활성 값, KV 캐시와 같은 중간 데이터가 GPU 사이를 오간다. GPU 간 연결 속도가 느리거나 경직돼 있으면 개별 GPU가 아무리 빨라도 전체 처리 속도는 낮아진다.
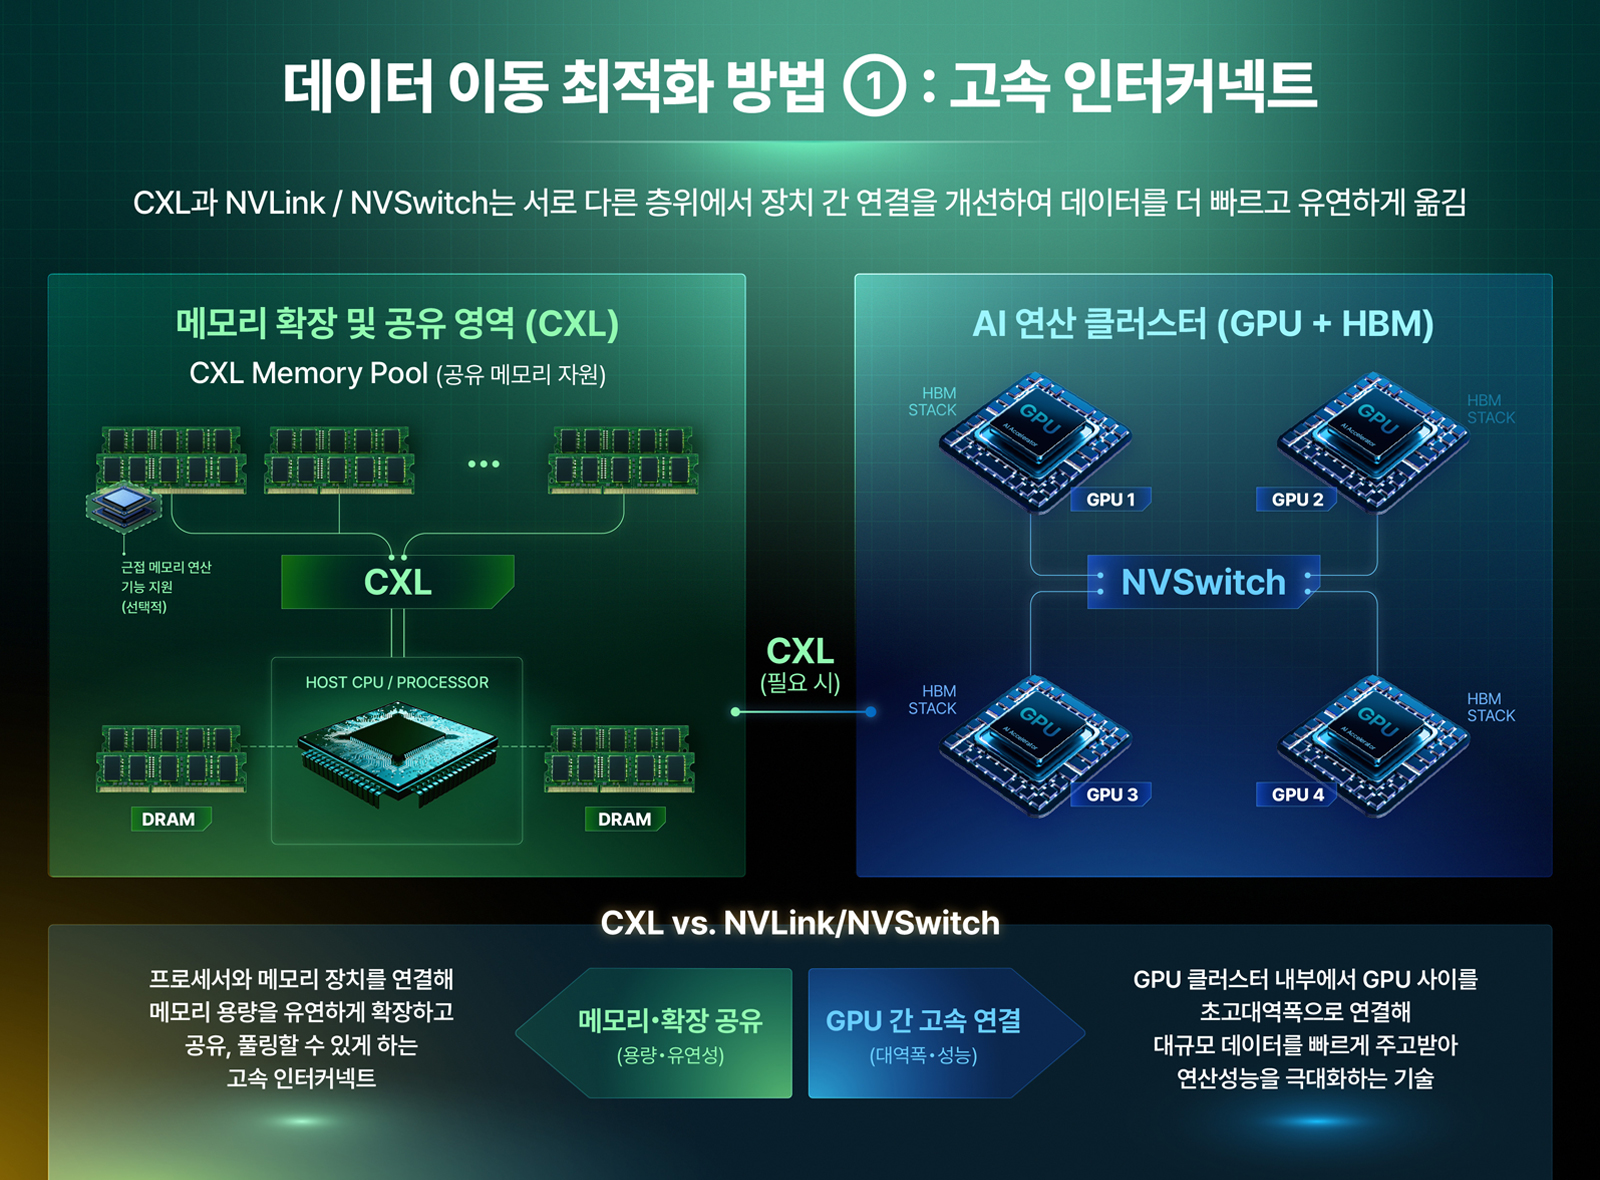
CXL과 NVLink/NVSwitch는 담당하는 영역이 다르다. CXL은 메모리 확장과 공유를 지원하고, NVLink/NVSwitch는 GPU 간 고속 통신을 맡는다. 적용 영역은 다르지만, 두 기술이 겨냥하는 지점은 같다. 데이터 이동 과정에서 생기는 병목을 줄이고, 시스템 자원을 더 효율적으로 쓰도록 하는 것이다. 이런 기반이 갖춰지면 메모리와 가속기는 특정 장치에 묶인 부품이 아니라, 워크로드에 맞춰 조합할 수 있는 시스템 자원이 된다.
고속 인터커넥트는 시스템 구성 방식도 바꾼다. 연산 장치와 메모리를 고정적으로 묶어두는 대신, 필요에 따라 배치하고 연결할 수 있게 한다. 그 결과 AI 인프라는 데이터를 먼 곳으로 반복해서 보내는 구조에서 벗어나, 데이터와 가까운 위치에서 필요한 처리를 수행하는 방향으로 나아간다.
상호 연결된 근접 메모리 가속기 구조: 데이터 근접 처리와 협력 연산
데이터 이동 병목을 줄이려면 연결 속도를 높이는 것만으로는 한계가 있다. CXL과 NVLink/NVSwitch가 메모리와 GPU/NPU/TPU 사이의 데이터 이동 경로를 개선하는 기술이라면, 근접 메모리 가속은 연산 기능을 데이터 가까이에 배치해, 중앙 연산 장치까지 오가야 하는 데이터의 양을 줄이는 접근이다.
중앙 GPU/NPU/TPU가 모든 데이터를 끌어와 처리하는 대신, 메모리 장치나 그 주변에 놓인 가속기가 각자 맡은 작업을 나누어 수행한다. 이 가속기들은 고속 인터커넥트로 긴밀하게 연결되어, 전체 데이터를 중앙 GPU/NPU/TPU로 보내지 않고 메모리 가까이에서 먼저 처리한 뒤 필요한 결과만 다른 장치와 주고받는다. 이처럼 HBM과 같은 3D 적층 고대역폭 메모리*나 대용량 메모리 가까이에서 연산이 이뤄지면 데이터 왕복이 줄어든다. 그만큼 지연시간과 전력 소모를 낮추고, 여러 노드로 확장하기도 쉬워진다. 이를 상호 연결된 근접 메모리 가속기 구조*라고 한다.
이러한 가능성은 ISCA 2015에 발표된 테서랙트* 설계에서도 확인된다. 테서랙트는 여러 근접 메모리 가속기를 고속 인터커넥트로 연결해 병렬 그래프 처리에 적용한 연구 사례다. 메모리 가까이에 배치된 여러 가속기가 각자 데이터를 처리하고, 필요한 경우에만 서로 통신하도록 설계됐다. 이 연구는 다양한 병렬 그래프 처리 워크로드에서 기존 프로세서 중심 설계 대비 약 10배 수준의 성능 개선과 유사한 수준의 에너지 절감을 보였다*.
주목할 부분은 성능 개선 폭만이 아니다. 각 노드가 맡은 데이터를 가까운 곳에서 처리하고 통신량을 줄이면, 기존 구조보다 더 높은 확장성과 에너지 효율을 높일 수 있다. 가속기가 늘어날수록 메모리 용량과 대역폭, 연산 능력도 함께 확장된다. 따라서 핵심은 단순한 분산 처리라기보다, 여러 근접 메모리 가속기를 촘촘하게 연결해 각자 데이터를 처리하고, 필요한 결과만 주고받는 구조다.
* 상호 연결된 근접 메모리 가속기 구조(Distributed System Of Tightly-Connected Near-Memory Accelerators): 메모리 가까이에 배치된 여러 가속기를 고속 인터커넥트로 연결해, 각 가속기가 맡은 데이터를 처리하고 필요한 결과만 교환하도록 설계한 구조
* 테서랙트(Tesseract): 메모리 가까이에 배치된 여러 가속기를 고속 인터커넥트로 긴밀하게 연결해, 각 가속기가 맡은 데이터를 처리하고 필요한 경우에만 통신하도록 설계한 근접 메모리 가속기 구조 연구 사례
* Junwhan Ahn, Sungpack Hong, Sungjoo Yoo, Onur Mutlu, and Kiyoung Choi, “A Scalable Processing-in-Memory Accelerator for Parallel Graph Processing,” ISCA 2015
최근에는 LLM 추론을 겨냥한 연구도 이어지고 있다. ASPLOS* 2025에 발표된 CXL 기반 LLM 추론 연구는 CENT 설계를 통해 메모리 확장 구조와 근접 메모리 처리, 확장성 있는 인터커넥트를 결합했다. 이 방식은 대규모 추론 인프라에서 메모리 용량과 대역폭 부담을 크게 낮추고, 성능 · 에너지 · 비용 · 칩 면적 측면에서도 개선 효과를 냈다*. 메모리 용량과 대역폭 부담이 커질수록 모든 연산을 중앙 GPU/NPU/TPU로 집중시키는 방식만으로는 효율을 높이기 어렵다. CENT 설계와 같이 니어 메모리 프로세싱(Near-Memory Processing)과 효율적이고 확장 가능한 인터커넥트를 지능적이고 새로운 방식으로 활용해 데이터 이동을 최소화하는 분산형 니어 메모리 아키텍처는 성능, 에너지, 비용, 하드웨어 면적 등 모든 지표를 동시에 개선할 수 있다.
* Yufeng Gu, Alireza Khadem, Sumanth Umesh, Ning Liang, Xavier Servot, Onur Mutlu, Ravi Iyer, and Reetuparna Das, “PIM Is All You Need: A CXL-Enabled GPU-Free System for Large Language Model Inference,” ASPLOS 2025
분리형 아키텍처: 자원 풀링과 워크로드 맞춤 배치
분리형 아키텍처*도 같은 문제의식에서 출발하지만, 접근 방식은 조금 다르다. 근접 메모리 가속기 구조가 연산을 데이터 가까이에 배치한다면, 분리형 아키텍처는 CPU · GPU/NPU/TPU · 메모리 · 스토리지 · 네트워크 자원을 시스템 차원의 공유 풀로 구성한다. 워크로드의 성격에 따라 필요한 자원을 조합하는 방식이다. 큰 메모리 용량이 필요한 작업은 확장된 메모리 풀을 쓰고, 대역폭 요구가 큰 작업은 메모리 인접 가속기에서 처리한다. 자원을 고정된 서버 구성에 맞추지 않고, 워크로드가 요구하는 방식에 따라 배치하는 셈이다.
이러한 방향은 에너지 효율과 성능을 높이기 위해 맞춤형 · 유연형 · 재구성형 처리를 강조한 ‘Asymmetry Everywhere’ 연구 목적과도 맞닿아 있다*.
* Onur Mutlu, “Asymmetry Everywhere (with Automatic Resource Management),” CRA Workshop on Advancing Computer Architecture Research, 2010
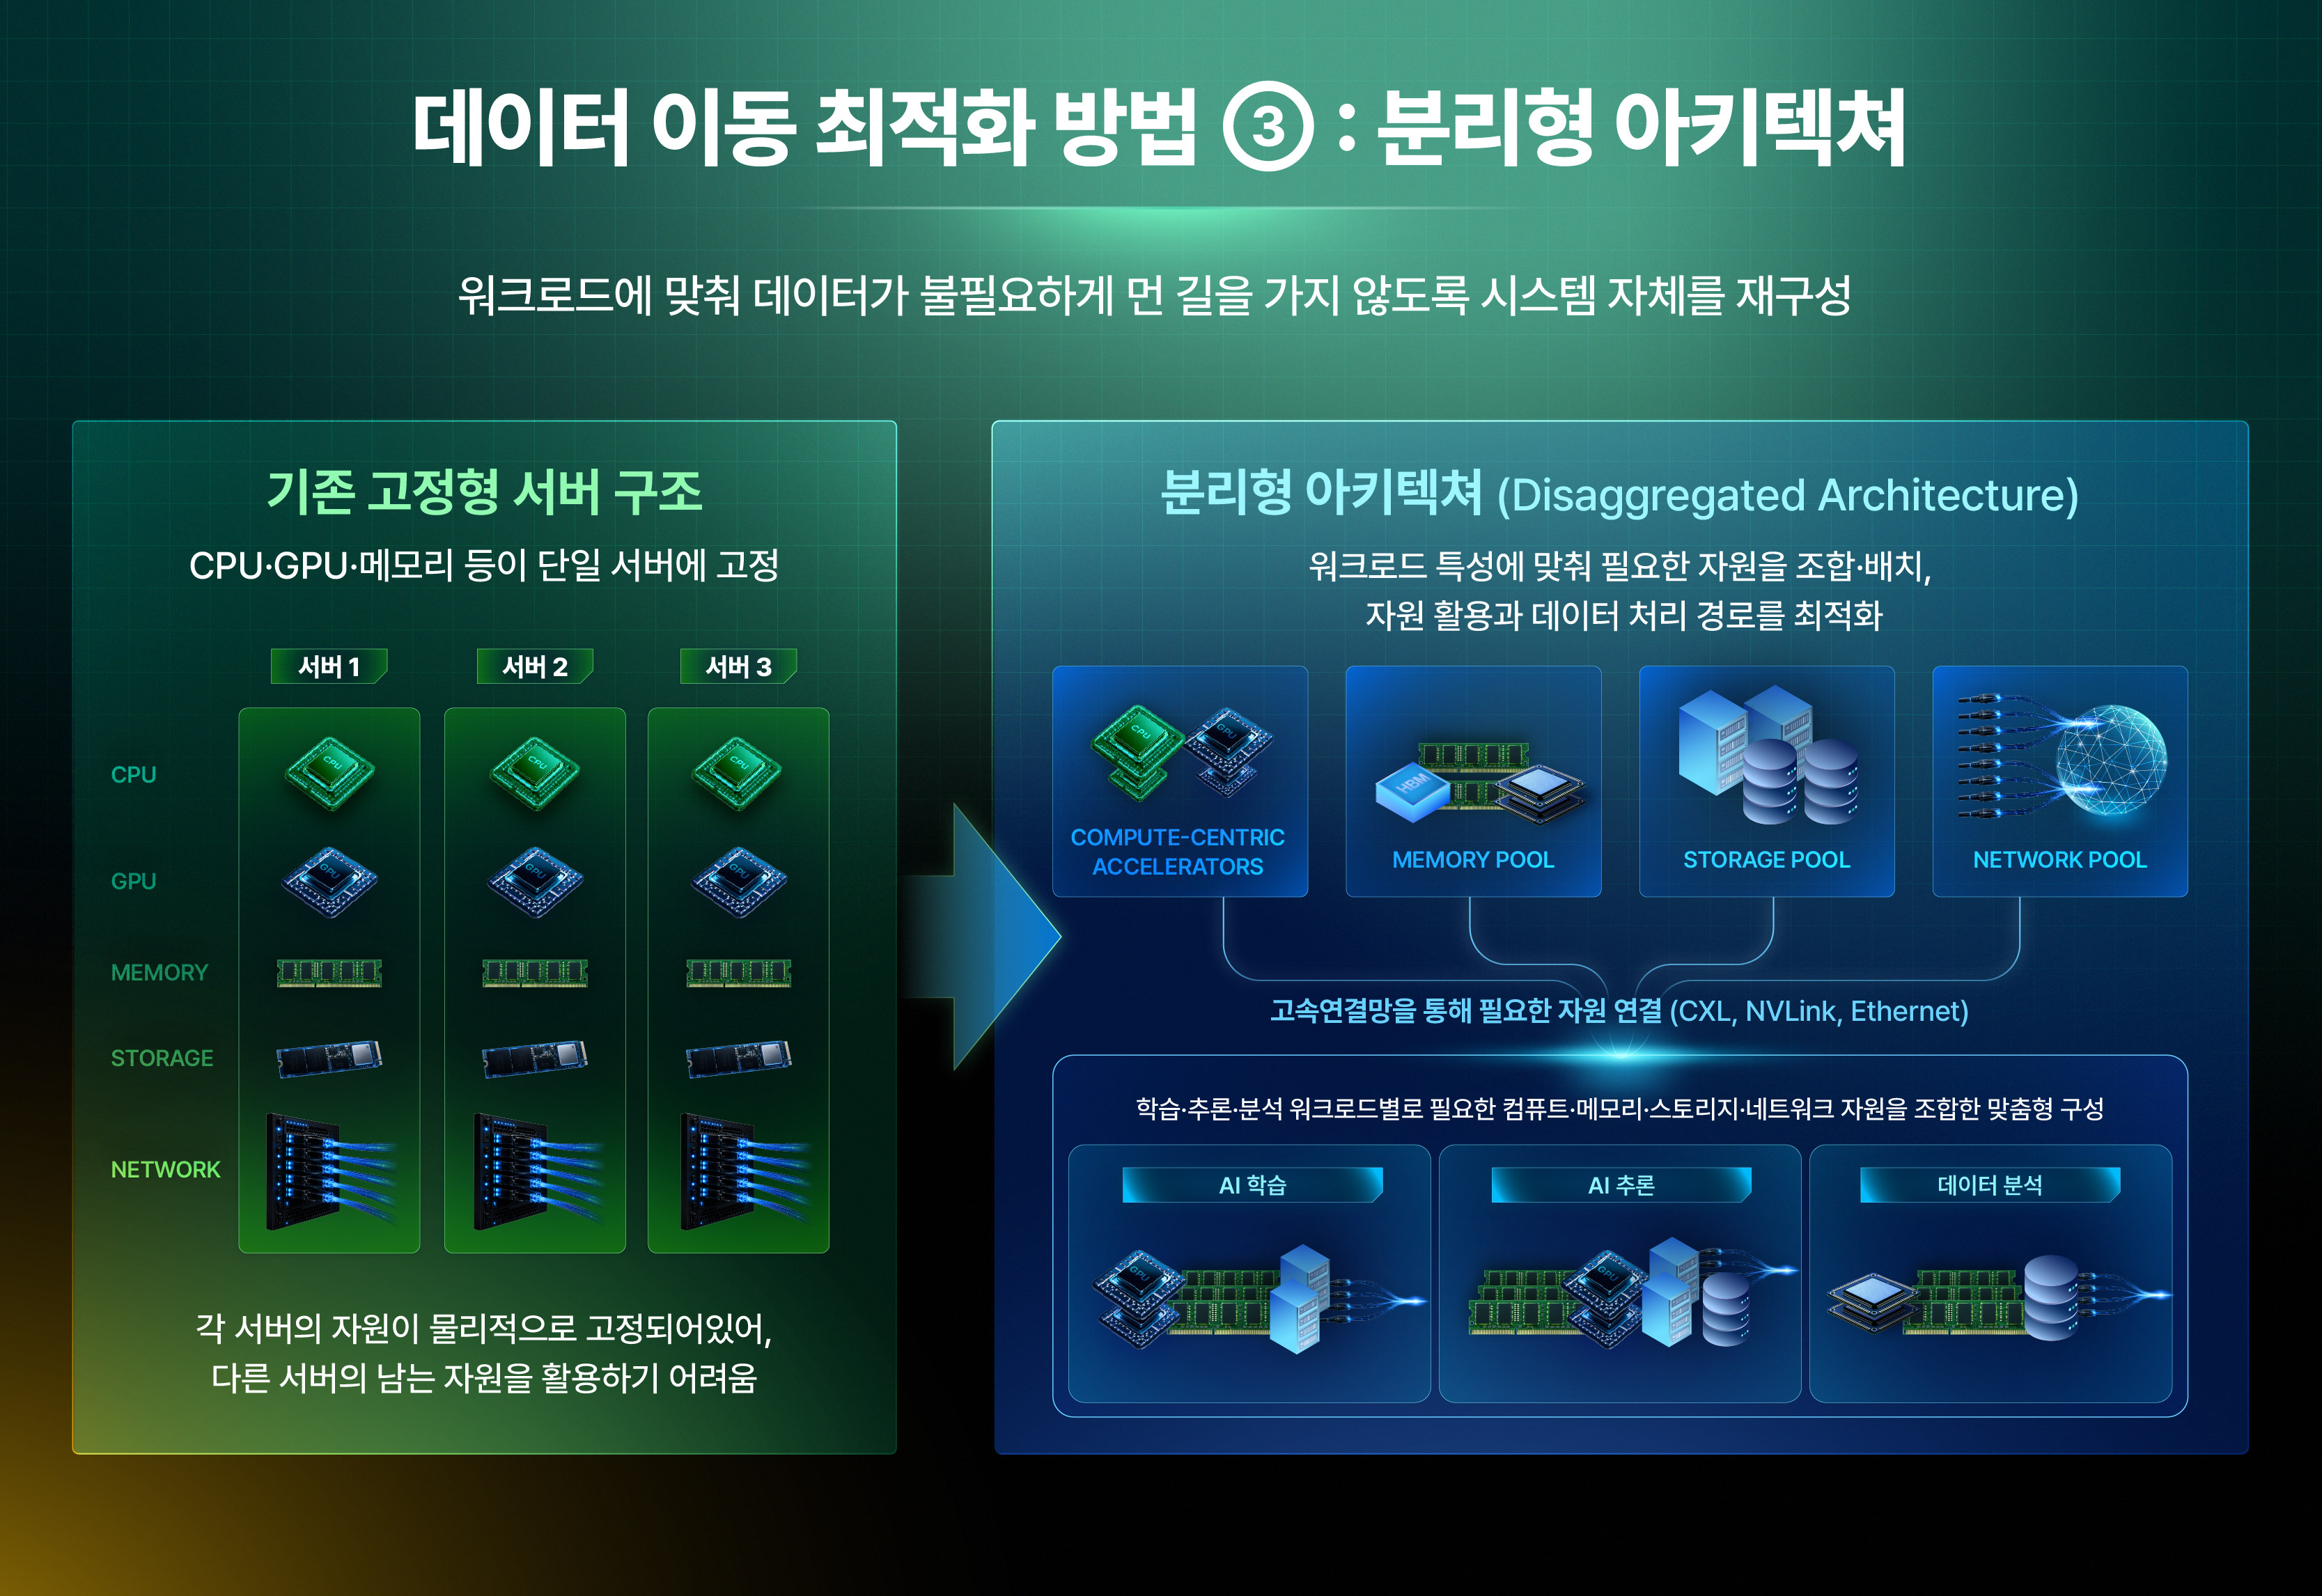
KV 캐시처럼 메모리 용량을 크게 요구하는 데이터나, 어텐션 레이어*처럼 메모리 접근 부담이 큰 연산은 이러한 구조의 대표적인 적용 대상이다. 고속 인터커넥트와 연산 기능을 갖춘 유연한 메모리 구성이 갖춰지면, KV 캐시 같은 데이터나 어텐션 레이어 같은 연산을 별도 메모리 자원 또는 근접 메모리 가속 영역에 배치한다. 이 구조에서는 GPU/NPU/TPU들이 모든 데이터를 직접 가져와 처리하지 않는다. 필요한 데이터와 연산을 적절한 위치에 나누고, 장치 간에는 필요한 결과만 주고받는다.
분리형 구조의 성패는 자원 배치와 통신 비용의 균형에서 갈린다. 통신량이 지나치게 많으면 지연시간과 에너지 부담이 오히려 커진다. 따라서 무엇을 분리할지, 무엇을 메모리 가까이에 둘지, 어떤 연산을 어디에서 수행할지 함께 따져야 한다.
재구성 가능한 AI 인프라
AI 인프라의 경쟁력은 개별 부품의 속도보다, 워크로드에 맞는 데이터 경로와 자원 배치를 얼마나 정교하게 설계하느냐에서 갈린다. CXL과 NVLink 같은 고속 인터커넥트, 테서랙트 같은 근접 메모리 가속기 구조, CXL 기반 메모리 풀링과 맞춤형 근접 메모리 처리를 활용한 분리형 아키텍처도 같은 방향을 가리킨다. 주요 빅테크와 클라우드 사업자가 AI 인프라 구조에 막대한 투자를 이어가는 이유도 여기에 있다. 이제 AI 경쟁의 경제성은 연산 장치를 얼마나 많이 확보하느냐로 결정되지 않는다. 메모리를 설계의 중심에 두고 전력 · 메모리 · 네트워크 · 실리콘을 얼마나 효율적으로 활용해 데이터 이동을 최소화하면서 추론 성능을 끌어올리느냐에 달려 있다.
AI 인프라는 고정된 설비에서 워크로드에 따라 구성이 달라지는 시스템으로 바뀌고 있다. 모델이 커지고, 문맥이 길어지고, 추론 호출이 늘어날수록 인프라는 더 유연하고 효율적으로 움직여야 한다. 워크로드와 모델에 맞춰 경로를 고르는 능력이 중요해진다.
시스템 구조가 빠르게 달라지면서 메모리의 역할도 함께 달라진다. 지금까지 메모리는 주로 데이터를 저장하고 공급하는 장치로 여겨졌다. 그러나 AI 워크로드에서는 데이터가 저장된 위치와 연산이 수행되는 지점 사이의 거리가 성능과 전력 효율을 좌우한다. 이에 따라 메모리는 데이터 저장 · 공급 장치에 머물지 않는다. 연산 위치와 시스템 효율을 함께 정하고, 일부 연산까지 맡는 설계 요소로 바뀌고 있다.
최근 연구에서는 기존 D램 칩이 데이터 저장을 넘어 일부 연산에도 활용될 수 있다는 점이 확인됐다*. 메모리 컨트롤러*의 접근 방식을 조정하고 여러 행을 동시에 활성화하면, D램 내부에서 대규모(TOPS 수준)* 비트 연산이나 데이터 복사 · 초기화 작업이 이뤄진다. 이는 D램 회로가 작동하는 기본 원리에서 비롯된다. 연구진은 이를 ‘D램 내부 연산(processing-using-DRAM)’이라고 설명한다. 기존 D램 칩 안에 연산 가능성이 있다는 점을 확인한 사례이자, 향후 D램 칩과 표준안에 새로운 D램 내부 처리 메커니즘을 반영할 수 있는 기반이 된다.
AI 성능은 사양표에 적힌 개별 부품의 합산 값만으로 설명하기 어렵다. 앞으로의 경쟁력은 데이터가 있는 위치를 기준으로 어떤 연산을 어디에서 수행하고, 어느 장치가 연산을 맡으며, 어떤 경로로 결과를 주고받도록 설계하느냐에서 갈린다.
* 메모리 컨트롤러(Memory Controller): 프로세서와 메모리 사이에서 데이터 읽기 · 쓰기 명령과 타이밍을 제어하는 장치
* TOPS(Tera Operations Per Second): 초당 수행 가능한 연산 횟수를 조 단위로 나타내는 처리량 지표. 1 TOPS는 초당 1조 회의 연산을 의미하며, 여기서는 D램 내부에서 수행하는 비트 단위 연산의 처리 규모를 나타낸다.
다음 질문: 반도체의 무게중심은 왜 메모리로 이동하는가
AI 인프라의 병목은 GPU나 메모리와 같은 개별 구성요소뿐만 아니라, 특히 연산이 어떻게 분산되고 통신이 어떻게 이루어지는지, 즉 GPU/NPU/TPU, HBM, 스토리지, 네트워크, 인터커넥트가 서로 데이터를 주고받는 방식에서 발생한다. 특히 프로세서 중심 구조는 막대한 데이터 이동을 만들고, 이 부담이 오늘날 AI 인프라의 핵심 병목으로 드러나고 있다. 앞서 살펴본 고속 인터커넥트, 근접 메모리 가속기 구조, 분리형 아키텍처는 모두 데이터 이동 부담을 줄이기 위한 시스템 차원의 접근이다.
이제 질문은 반도체와 메모리 자체의 구조로 이어진다. 데이터를 연산 장치 가까이에 배치하는 것을 넘어, 메모리 안팎에서 일부 연산까지 수행해 데이터 이동을 더욱 줄일 수 있는지가 다음 과제다. 다음 편에서는 AI 반도체의 무게중심이 왜 HBM, 첨단 패키징, PIM 등 메모리 쪽으로 이동하고 있는지 살펴본다.
※본 콘텐츠는 AI/반도체 산업에 관한 인사이트를 제공하는 외부 전문가 칼럼 콘텐츠로, SK하이닉스의 공식 입장과는 다를 수 있습니다.