SK하이닉스는 HBM(High Bandwidth Memory) · D램 · 낸드플래시 등 메모리 전 분야에서 AI 시스템에 최적화된 풀 스택 AI 메모리 설루션을 선보이고 있다. 그 토대에는 구성원들이 땀 흘려 일군 다양한 혁신 기술이 자리한다. 뉴스룸은 이들 기술의 원천이자, 비전의 발판이 된 연구 논문을 소개하고자 [Research Inside] 시리즈를 시작한다.
2편에서는 3D FeNAND 기반 아날로그 컴퓨팅 인 메모리(A-CiM, Analog Computation-in-Memory)의 효율을 높이기 위해 셀(Cell), 비셀(Non-Cell), 페이지(Page) 연산 방식을 공동 최적화한 접근을 조명한다.
[논문 바로가기]
· 제목: Co-Optimizing Cell, Non-Cell, and Page Schemes for Energy Efficient Analog Computing in 3D FeNAND
· 발행: 2025 IEEE International Electron Devices Meeting (IEDM)
· 저자: SK하이닉스 구원태 TL(Global RTC), 김지훈 TL(Global RTC)
(Summary) | (Full Text)
연구 배경: AI 연산을 위한 새로운 낸드의 필요성
AI 모델의 규모가 커질수록 데이터 이동에 따른 전력 소모와 지연은 AI 인프라의 주요 병목으로 떠오르고 있다. SK하이닉스 연구팀은 이를 줄이기 위해 저장과 연산을 결합한 아날로그 컴퓨팅 인 메모리 (A-CiM)* 구조에 주목했다. 그리고 3D FeNAND를 기반으로 셀 · 비셀 · 페이지를 공동 최적화하는 접근을 제시했다.
이제 AI 연산 성능은 연산 장치의 속도만으로 설명하기 어렵다. 데이터를 어디에 저장하고, 어디에서 연산하며, 이동을 얼마나 줄일 수 있는지가 시스템 효율에 직접적인 영향을 준다. 이런 배경에서 주목받는 기술이 컴퓨팅 인 메모리(CiM)다. CiM은 데이터를 연산 장치로 계속 옮기지 않고, 메모리 내부 또는 가까운 곳에서 처리해 이동 부담을 줄이는 기술이다.
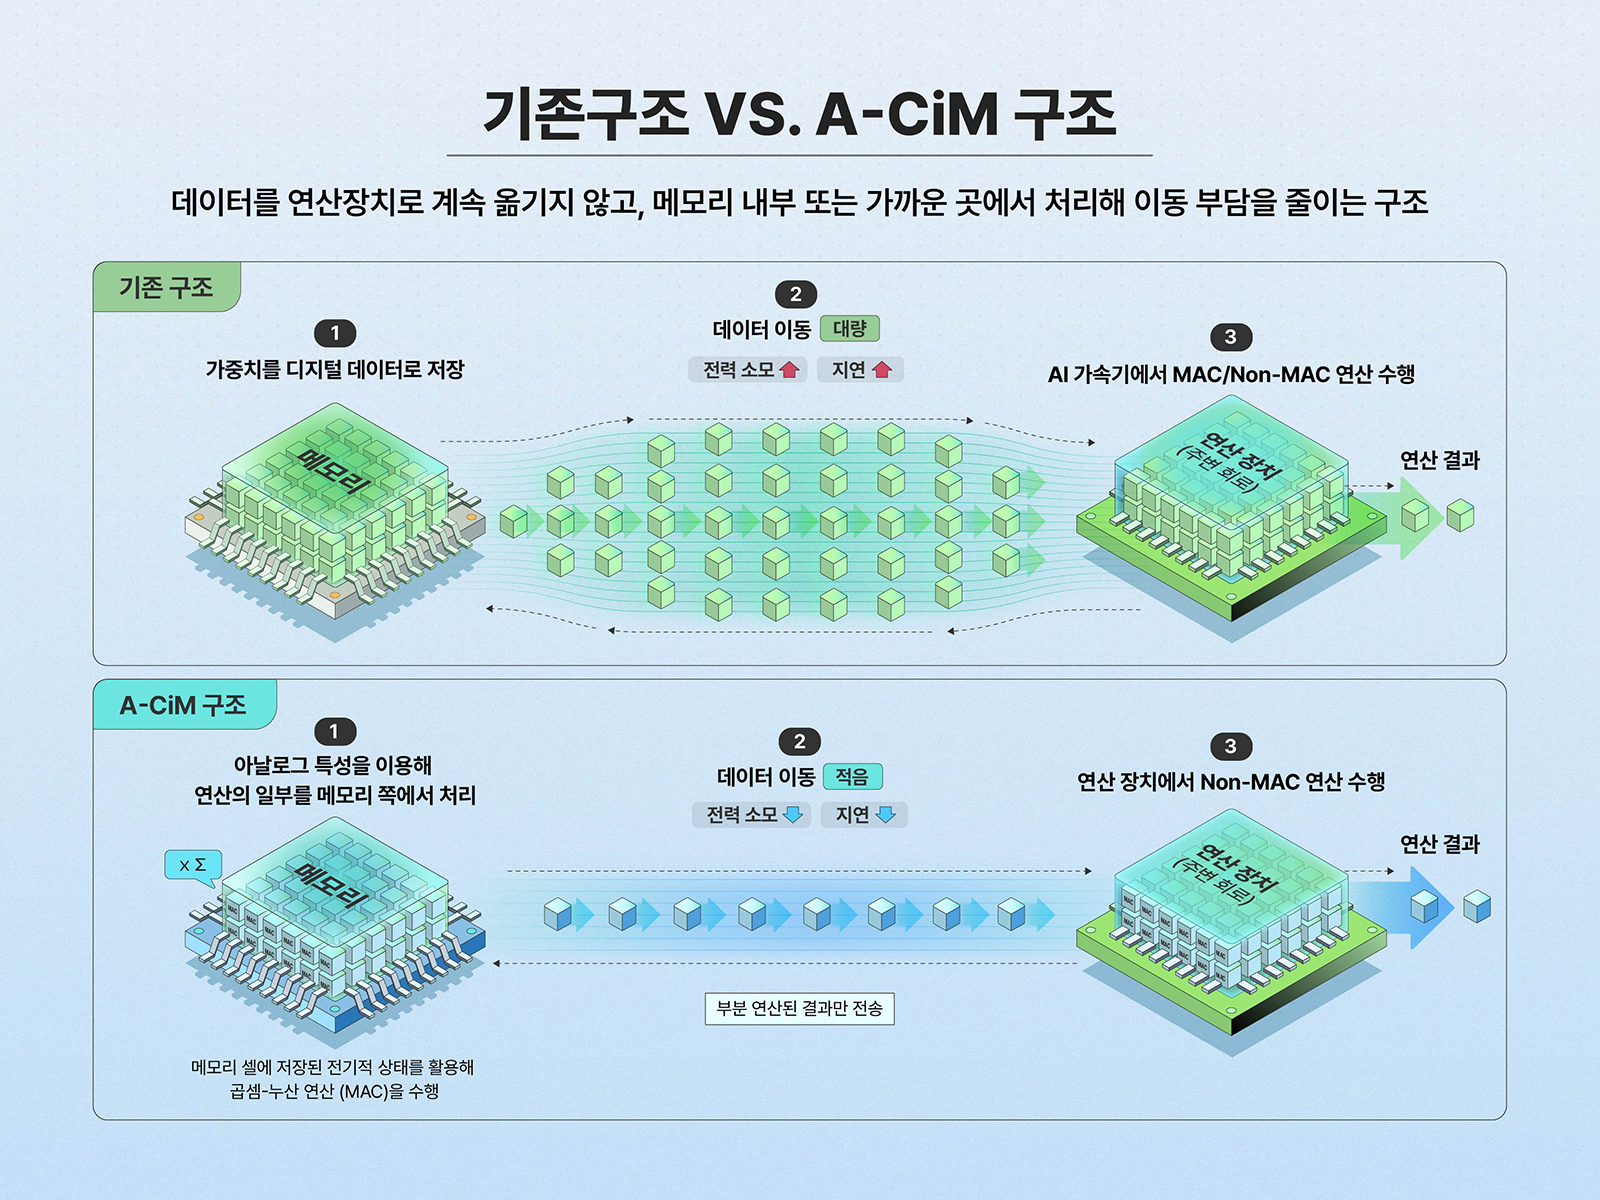
그중 A-CiM은 메모리 셀에 저장된 전기적 상태를 활용해 AI 연산의 기본 단위인 곱셈-누산*을 수행한다. AI 모델이 커질수록 저장하고 반복적으로 읽어야 할 가중치 데이터도 늘어난다. 이 때문에 많은 데이터를 높은 밀도로 담을 수 있는 구조가 A-CiM 구현의 필수 조건으로 떠오르고 있다.
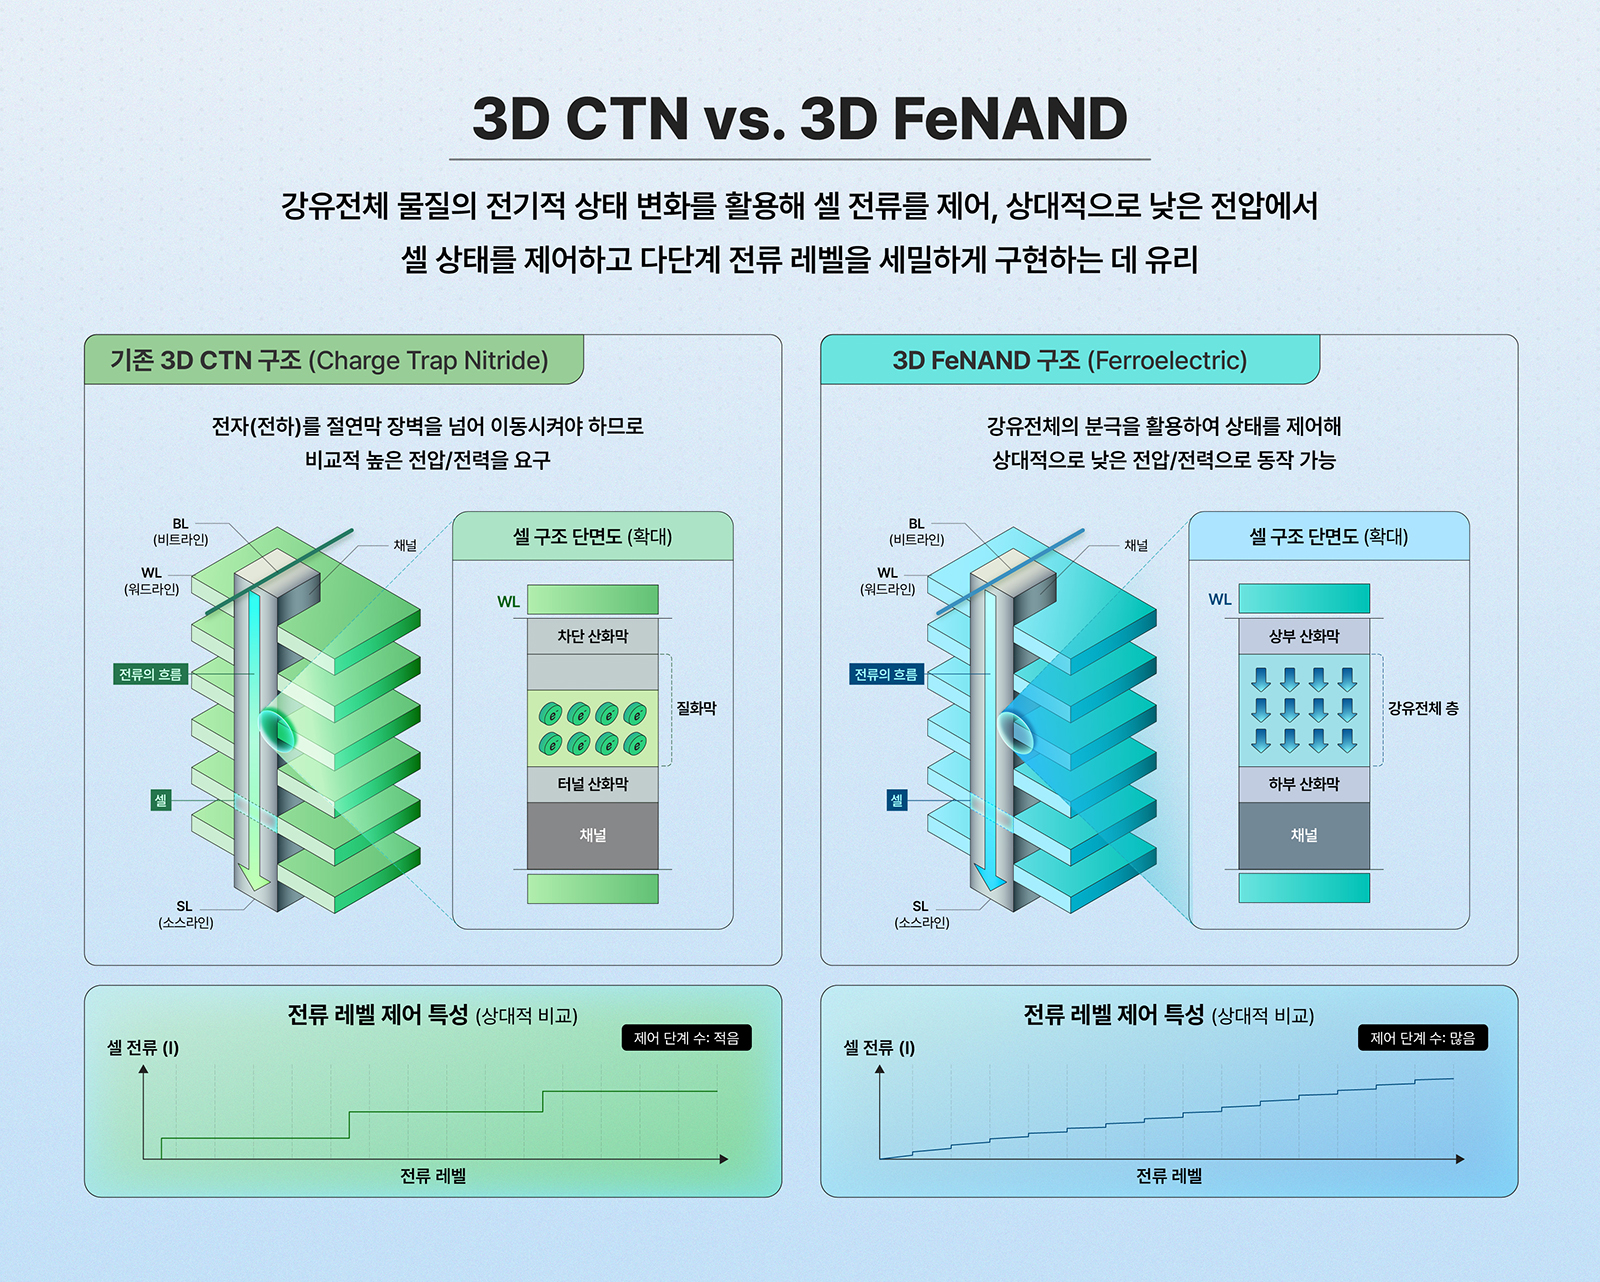
A-CiM에 적합한 메모리 구조로는 3D FeNAND*가 주목된다. 현재 상용 3D 낸드는 주로 CTN (Charge Trap Nitride) 구조를 사용한다. CTN은 전자를 질화막 안에 가두거나 빼내는 방식으로 셀 상태를 제어한다. 집적도 측면에서는 강점이 있지만, 아날로그 연산에 필요한 전류 레벨을 여러 단계로 정밀하게 구분하는 데에는 한계가 있다.
반면 FeNAND는 강유전체* 물질의 전기적 상태 변화를 활용해 셀 전류를 제어한다. 강유전체는 외부 전기장을 제거해도 내부 분극 상태를 유지하는 물질로, 이 분극 상태를 바꿔 데이터를 저장하거나 셀 상태를 조절할 수 있다. 이 특성 덕분에 FeNAND는 기존 3D CTN 낸드보다 낮은 전력으로 다단계 전류 레벨을 세밀하게 제어하는 데 유리하다.
다만 3D FeNAND를 A-CiM에 적용하려면 셀 구조만 바꿔서는 부족하다. 셀이 전류 레벨을 안정적으로 구분하더라도, 이를 선택하고 제어하는 배선에서 전력 손실이 크면 전체 성능은 제한된다. 배선 부담을 줄이더라도, AI 모델의 데이터 크기와 연산 순서에 맞춰 페이지를 활용하지 못하면 불필요한 전환과 지연이 다시 생긴다.
연구팀이 셀, 비셀, 페이지를 공동 최적화한 것도 이런 이유 때문이다. 3D FeNAND의 잠재력을 실제 A-CiM 효율로 연결하려면 셀의 전류 레벨 제어, 워드라인* 전환 부담, 페이지 활용 방식을 하나의 구조 안에서 통합적으로 개선해야 한다.
* 강유전체(Ferroelectric): 외부 전기장을 제거해도 내부 분극 상태를 유지하는 물질. 이 분극 방향을 전기적으로 바꿀 수 있어, 메모리 소자의 데이터 저장이나 셀 상태 제어에 활용된다.
* 워드라인(Word Line): 메모리 셀을 선택하고 제어하는 배선. 특정 셀 또는 셀 그룹을 읽거나 쓰기 위해 전압을 인가한다.
연구 성과: 셀 · 비셀 · 페이지 공동 최적화 설계
이번 연구의 차별점은 셀, 비셀, 페이지를 따로 개선하는 대신 통합적으로 최적화했다는 점이다. A-CiM에서 셀은 다단계 전류 레벨을 정밀하게 표현해야 하고, 비셀은 그 상태를 선택하고 제어하는 과정에서 전력 손실을 줄여야 한다. 페이지는 연산에 쓰일 데이터를 적절한 순서와 단위로 나눠 불필요한 전환을 낮추는 역할을 한다.
세 요소 중 하나라도 병목이 남으면 전체 성능은 제한된다. 셀이 값을 정밀하게 표현해도 워드라인 전환 부담이 크면 전력 효율이 떨어진다. 배선 부담을 낮춰도 페이지 안의 데이터 구성이 비효율적이면 지연 시간이 다시 늘어난다. 따라서 이 세 축을 동시에 고려하는 공동 최적화* 접근으로 3D FeNAND 기반 A-CiM의 처리량과 에너지 효율을 높였다.
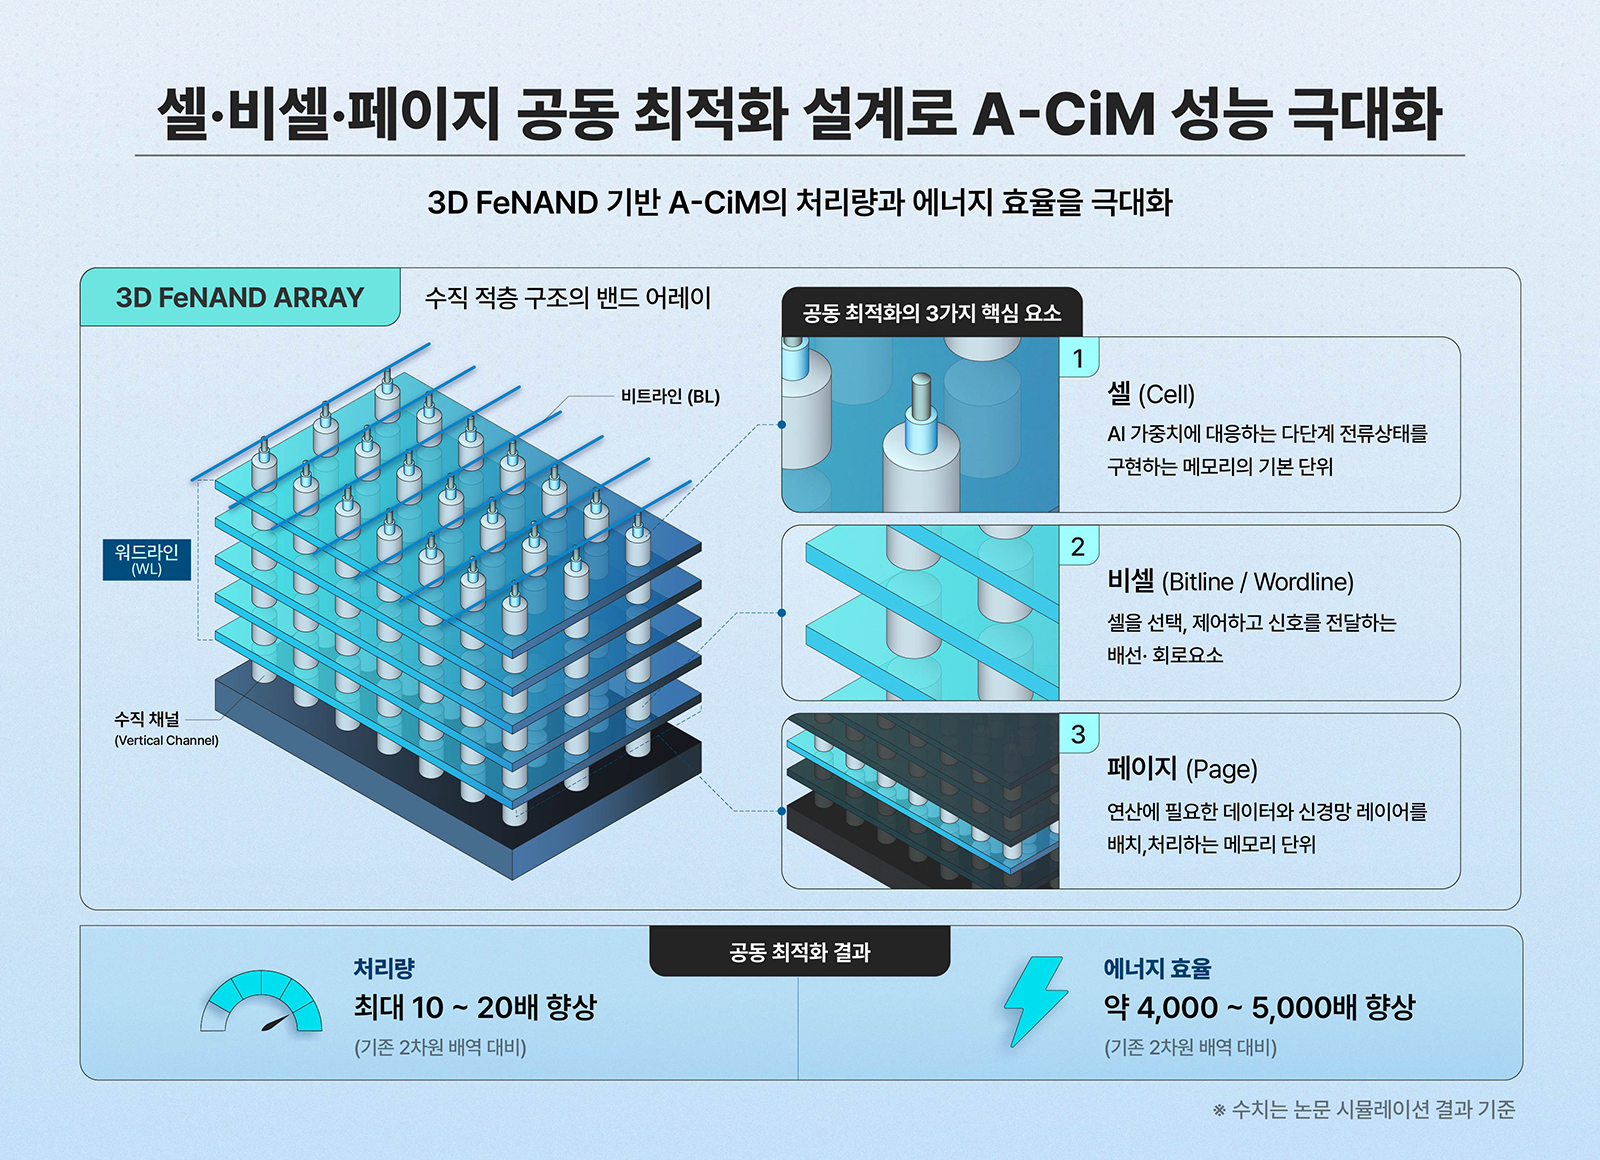
공동 최적화의 성과는 수치로도 확인됐다. 시뮬레이션 결과, 최적화된 3D FeNAND는 기존 3D 낸드 기반 구조 대비 처리량과 에너지 효율을 크게 높였다. 제한된 칩 크기 조건에서 기존 2차원 배열과 비교했을 때도 처리량은 약 10~20배, 에너지 효율은 약 4,000~5,000배 수준으로 향상됐다. 이는 3D FeNAND의 높은 집적도와 셀 · 비셀 · 페이지 공동 최적화에 따른 데이터 이동 감소 효과가 반영된 결과다.
이번 결과는 메모리의 집적도 향상만으로는 설명하기 어려운 성능 개선이 시스템 수준의 최적화에서 비롯될 수 있음을 시사한다. AI 연산 효율은 데이터를 얼마나 많이 저장하느냐만으로 정해지지 않는다. 저장된 데이터를 어떤 전류 상태로 구분하고, 어떤 배선으로 제어하며, 어떤 순서와 단위로 계산에 투입하느냐가 전체 성능을 좌우한다.
이번 연구는 낸드의 활용 범위를 AI 시스템에 맞춰 확장했다는 점에서도 의미가 있다. AI 시대의 낸드는 단순히 데이터를 많이 저장하는 장치에 머물지 않는다. 대규모 AI 모델의 가중치를 높은 밀도로 담고, 데이터 이동과 재기록에 따른 에너지 부담을 줄이며, 연산 효율까지 높이는 방향으로 진화하고 있다.
3D FeNAND 기반 A-CiM은 높은 집적도와 낮은 전력 소모, 멀티레벨 제어 특성을 바탕으로 낸드가 저장 매체를 넘어 연산 매체로 확장될 수 있음을 뒷받침한다. 특히 셀, 비셀, 페이지를 공동 최적화한 이번 연구는 낸드 구조를 AI 워크로드에 맞춰 시스템 수준에서 설계할 수 있다는 가능성을 제시한다.
연구 핵심: 셀 · 비셀 · 페이지별 최적화 전략
3D FeNAND 기반 A-CiM의 병목을 셀, 비셀, 페이지 세 영역으로 나누고 각각 최적화 전략을 제시했다. 셀은 데이터를 어떤 전류 상태로 표현할지에 관한 영역이다. 비셀은 그 셀을 선택하고 제어하는 배선과 주변 구조에 해당한다. 페이지는 실제 AI 연산에 쓰이는 데이터를 어떤 단위와 순서로 구성할지와 관련된다. 세 영역은 서로 분리되어 보이지만, A-CiM에서는 실제 연산 과정에서 서로 긴밀하게 영향을 주고받는다.
☑ 최적화 포인트 1: 셀 – 다단계 전류 레벨의 정밀 제어
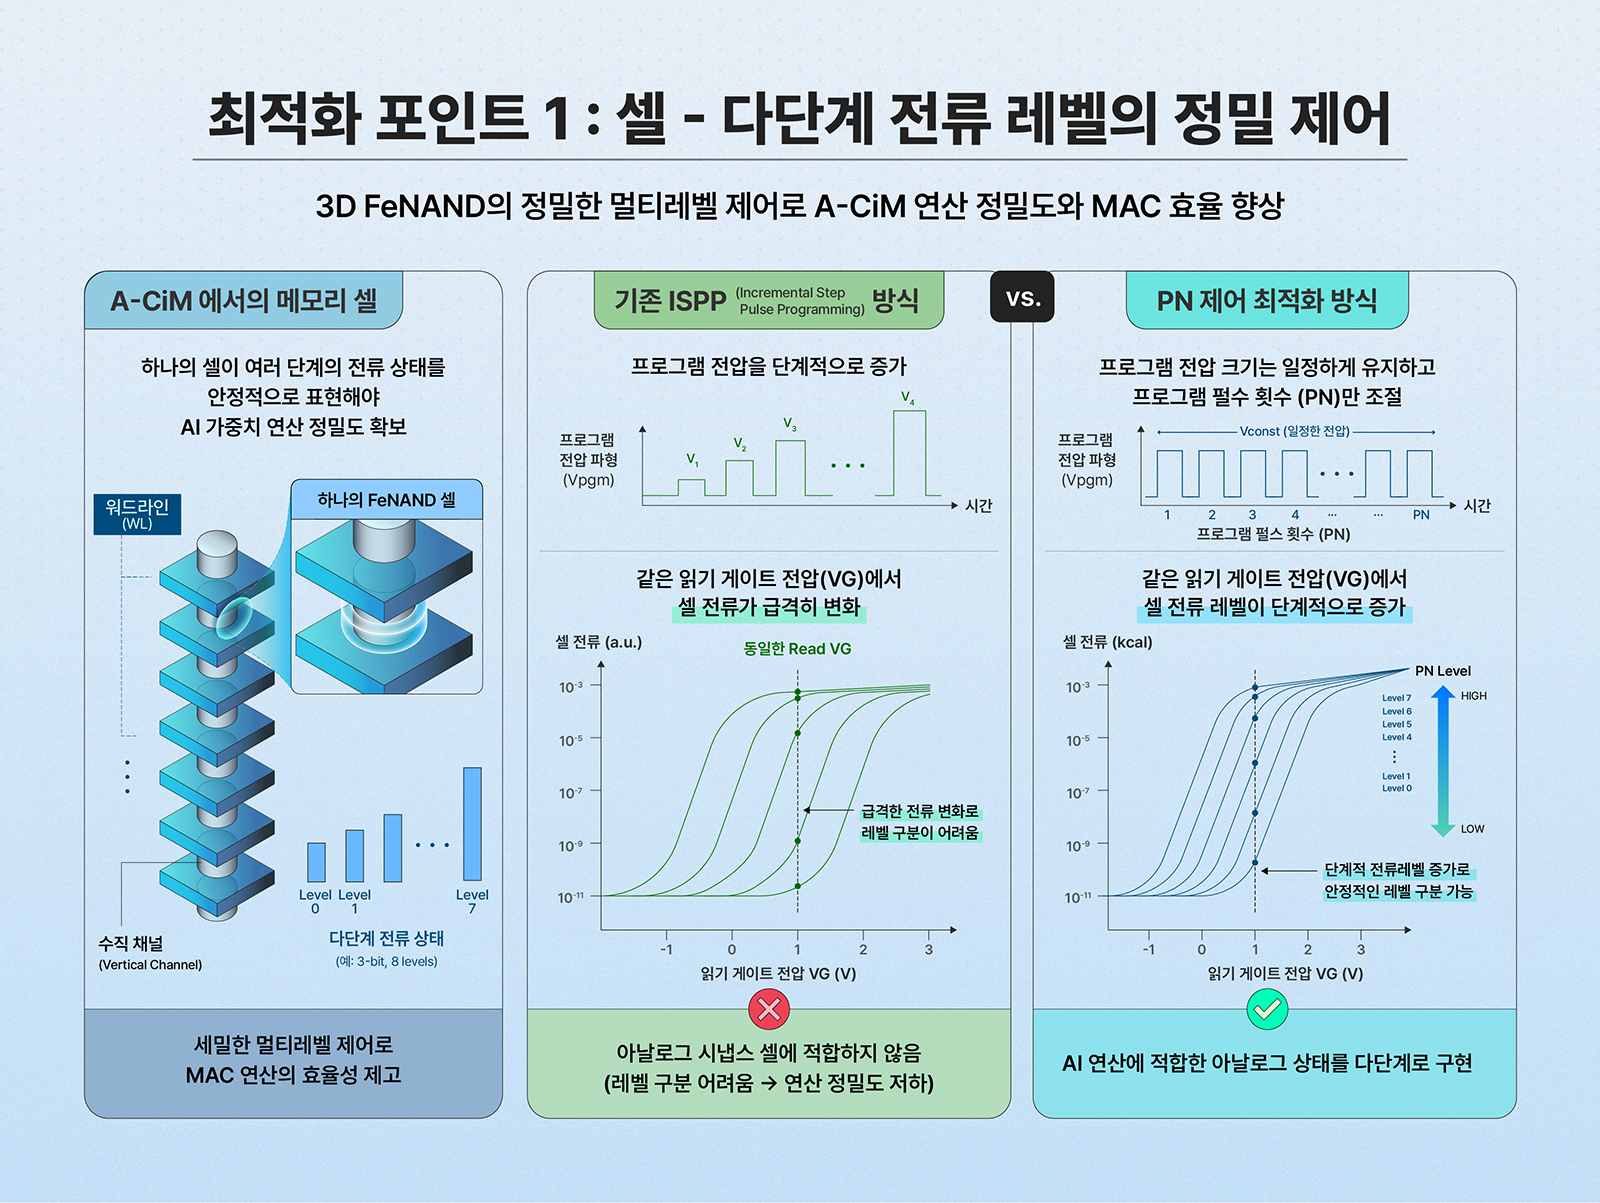
A-CiM에서 메모리 셀은 단순히 0과 1만 저장하지 않는다. AI 모델의 가중치를 세밀하게 저장하고 연산하려면 하나의 셀이 여러 단계의 전류 상태를 안정적으로 표현해야 한다. 멀티레벨* 특성이 충분하지 않으면 아날로그 연산의 정밀도가 낮아지고, 결과적으로 MAC 연산 효율도 떨어진다.
기존 낸드에서는 문턱전압*을 조절할 때 ISPP (Incremental Step Pulse Programming)* 방식을 주로 쓴다. ISPP는 프로그램 전압을 단계적으로 높여 메모리 셀의 문턱전압을 조절하는 방식이다. 그러나 ISPP 방식에서는 같은 읽기 게이트 전압 (VG)*에서 셀 전류가 급격히 변할 수 있다. 여러 전류 레벨을 부드럽게 구분해야 하는 아날로그 시냅스 셀에는 적합하지 않은 특성이다.
3D FeNAND에서는 동일 전압에서 프로그램 펄스 횟수*를 증가시키고, 이후 전압의 단계적 상승은 최소화하는 방식을 적용했다. 펄스 횟수가 늘어날수록 문턱전압은 점차 포화되는 양상을 보였고, 같은 읽기 게이트 전압에서 측정되는 셀 전류 레벨은 단계적으로 증가했다. 이런 점진적 변화로 AI 연산에 쓰이는 아날로그 상태를 여러 단계로 구분할 수 있다.
* 문턱전압(Vth): 메모리 셀에 전류가 흐르기 시작하는 기준 전압. 저장된 전하 또는 셀 상태에 따라 달라지며, 데이터 판독에 활용된다.
* ISPP(Incremental Step Pulse Programming): 프로그램 전압을 단계적으로 높여 메모리 셀의 문턱전압을 조절하는 방식이다.
* 읽기 게이트 전압(Read Gate Voltage, VG): 메모리 셀의 상태를 읽기 위해 게이트에 가하는 전압. 같은 읽기 게이트 전압에서 셀 전류가 어떻게 달라지는지를 보면, 셀이 서로 다른 아날로그 상태를 얼마나 안정적으로 구분하는지 확인할 수 있다.
* 프로그램 펄스 횟수(Pulse Number): 메모리 셀의 상태를 바꾸기 위해 가하는 프로그램 펄스의 횟수. 이번 연구에서는 PN을 조절해 여러 단계의 셀 전류 상태를 구분했다.
FeNAND의 강점은 전류를 제어하는 방식에서도 드러난다. 기존 CTN 낸드는 질화막에 저장된 전자의 양을 조절해 셀 상태를 바꾼다. 반면 FeNAND는 HZO* 계열 강유전체 물질의 도메인 스위칭*을 이용한다. 이런 특성은 저전류 영역에서의 정밀한 멀티레벨 동작으로 이어진다. 300mm 웨이퍼 규모에서도 저전류 영역의 4레벨/셀 동작과 안정적인 데이터 보존 특성이 확인됐다.
* 도메인 스위칭(Domain Switching): 강유전체 내부의 분극 방향이 전기장에 의해 바뀌는 현상. FeNAND에서는 이를 통해 전류 상태를 조절할 수 있다.
☑ 최적화 포인트 2: 비셀 – 워드라인 전환 부담 완화
두 번째 과제는 셀 외부에서 발생한다. 낸드 구조에서 워드라인은 메모리 셀을 선택하고 제어하는 배선이다. A-CiM에서는 MAC 연산을 수행하는 동안 선택 워드라인과 비선택 워드라인이 반복적으로 바뀐다. 이 전환 과정에서 전력 소모와 지연 시간이 늘어난다.
워드라인 저항과 커패시턴스는 3D FeNAND 배열의 주요 비셀 요소다. 워드라인 저항과 커패시턴스가 크면 신호 전달이 늦어지고 선택 · 비선택 상태를 전환하는 데 더 많은 에너지가 든다. 비셀 최적화에서는 이 두 요소를 낮춰 전환 부담을 줄이는 것이 중요하다.
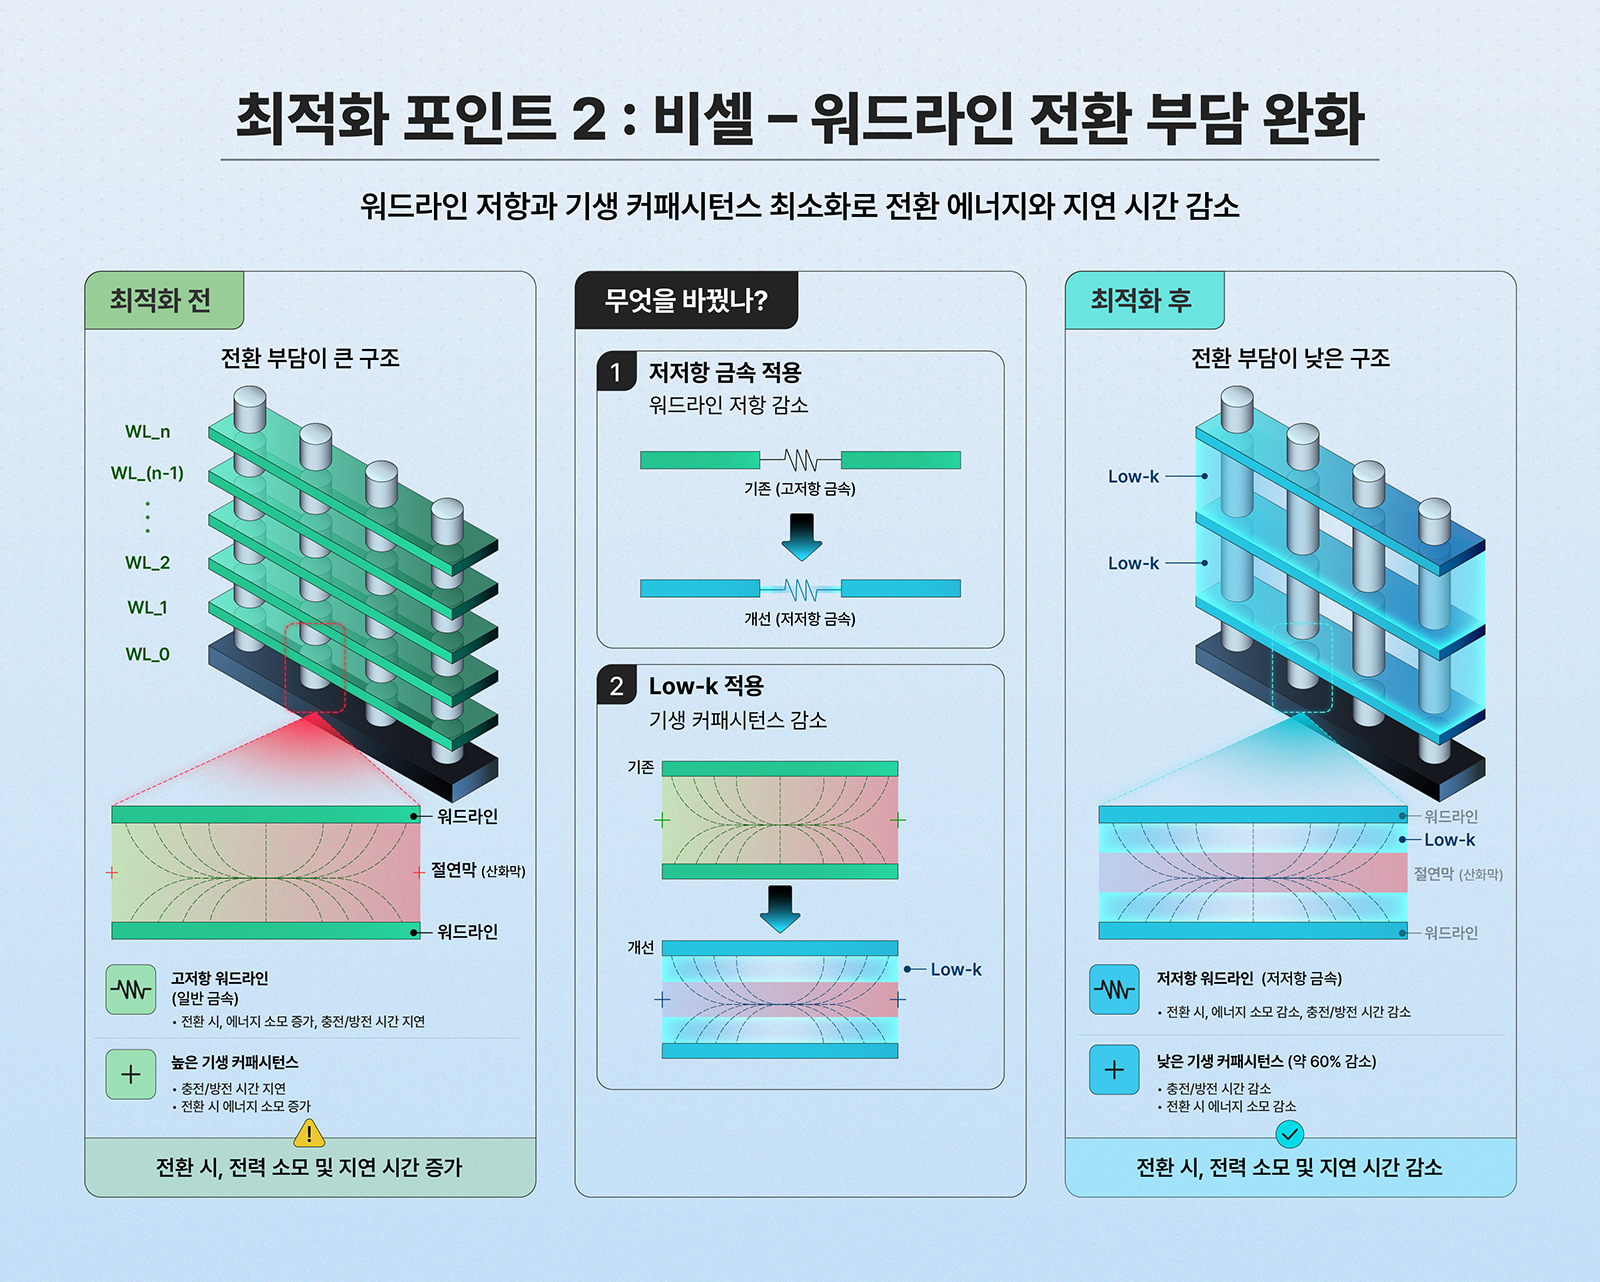
먼저 워드라인 금속 소재에 따른 성능 변화를 분석했다. 저저항 금속을 적용한 경우, 기준 구조 대비 처리량은 최대 16%, 에너지 효율은 최대 3% 개선됐다. 에너지 효율 개선 폭은 제한적이었다. 전체 전력 소모가 워드라인 저항보다 워드라인 커패시턴스의 영향을 더 크게 받기 때문이다.
워드라인 사이의 산화막에 에어갭*을 적용하면 기생 커패시턴스*를 약 60% 낮출 수 있다. 그 결과 처리량은 1.2배, 에너지 효율은 2배 향상됐다. 워드라인 저항과 커패시턴스를 공동 최적화했을 때는 처리량이 최대 1.4배, 에너지 효율이 최대 2.2배 높아졌다.
비셀 최적화는 셀에 구현된 아날로그 상태를 실제 연산으로 연결하는 통로를 효율화하는 작업이다. 셀이 정밀해도 워드라인을 바꾸는 과정에서 전력과 시간이 많이 들면 A-CiM의 장점은 줄어든다. 배선 부담을 낮추는 것만으로는 충분하지 않다. 연산할 데이터가 페이지 안에 어떻게 배치되는지에 따라 지연 시간과 전환 횟수가 다시 달라진다.
* 기생 커패시턴스: 워드라인처럼 가까이 배치된 배선 사이에서 의도치 않게 생기는 전기적 용량 성분. 한 배선에 전압을 인가할 때 인접 배선에도 영향을 줘 신호 지연과 전력 소모를 키울 수 있다.
☑ 최적화 포인트 3: 페이지 – 연산 순서와 데이터 배치 최적화
세 번째 과제는 페이지 단위의 연산 방식이다. A-CiM의 처리량은 한 페이지 또는 배열 안에서 얼마나 많은 입력을 병렬로 처리할 수 있는지에 따라 크게 달라진다. 페이지 간 전환 횟수도 처리량*과 에너지 효율*에 영향을 준다. 데이터를 많이 저장하더라도 연산에 쓸 값이 비효율적으로 구성되면 불필요한 전환이 늘고, MAC 연산 지연도 커진다.
첫 번째 페이지 최적화 방식은 인페이지 파이프라이닝*이다. IPP는 하나의 페이지 안에서 신경망 레이어*를 효율적으로 구성하고, 상황에 따라 레이어를 복제해 연산 병렬성을 높이는 방식이다. IPP는 MAC 연산 횟수와 워드라인 전환 횟수를 동시에 줄이도록 설계됐다.
시뮬레이션 결과, IPP는 기준 구조 대비 에너지 효율을 2배, 처리량을 9배 높였다. 페이지 안에서 데이터를 어떤 순서와 단위로 운용하느냐도 A-CiM 성능에 직접적인 영향을 준다는 뜻이다.
두 번째 페이지 최적화 방식은 페이지 분할*이다. 기존 16KB 페이지를 네 개의 4KB 서브페이지로 나누면 신경망 레이어의 입력·출력 크기에 맞춰 데이터를 더 유연하게 구성할 수 있다. 하나의 큰 페이지를 그대로 쓰는 대신 작은 단위로 나누면, 남는 서브페이지에 복제 레이어나 다른 신경망 레이어를 넣을 수 있다. 그 결과 작업에 배정되는 페이지 수가 줄고, 전환 에너지와 지연 시간, MAC 지연도 함께 낮아진다.
* TOPS/W(Tera Operations Per Second per Watt): 1와트당 수행 가능한 연산량을 나타내는 에너지 효율 지표다.
* 인페이지 파이프라이닝(IPP, In-Page Pipelining): 하나의 페이지 안에서 신경망 레이어 구성과 연산 순서를 최적화해 연산 횟수와 워드라인 전환을 줄이는 방식이다.
* 신경망 레이어(NN Layer): 인공신경망을 구성하는 계산 단계. 각 레이어는 입력을 받아 가중치와 연산한 뒤 다음 레이어로 전달한다.
* 페이지 분할(Page Splitting): 하나의 큰 페이지를 여러 개의 작은 서브페이지로 나눠 신경망 레이어의 입력·출력 크기에 맞게 활용하는 방식이다.
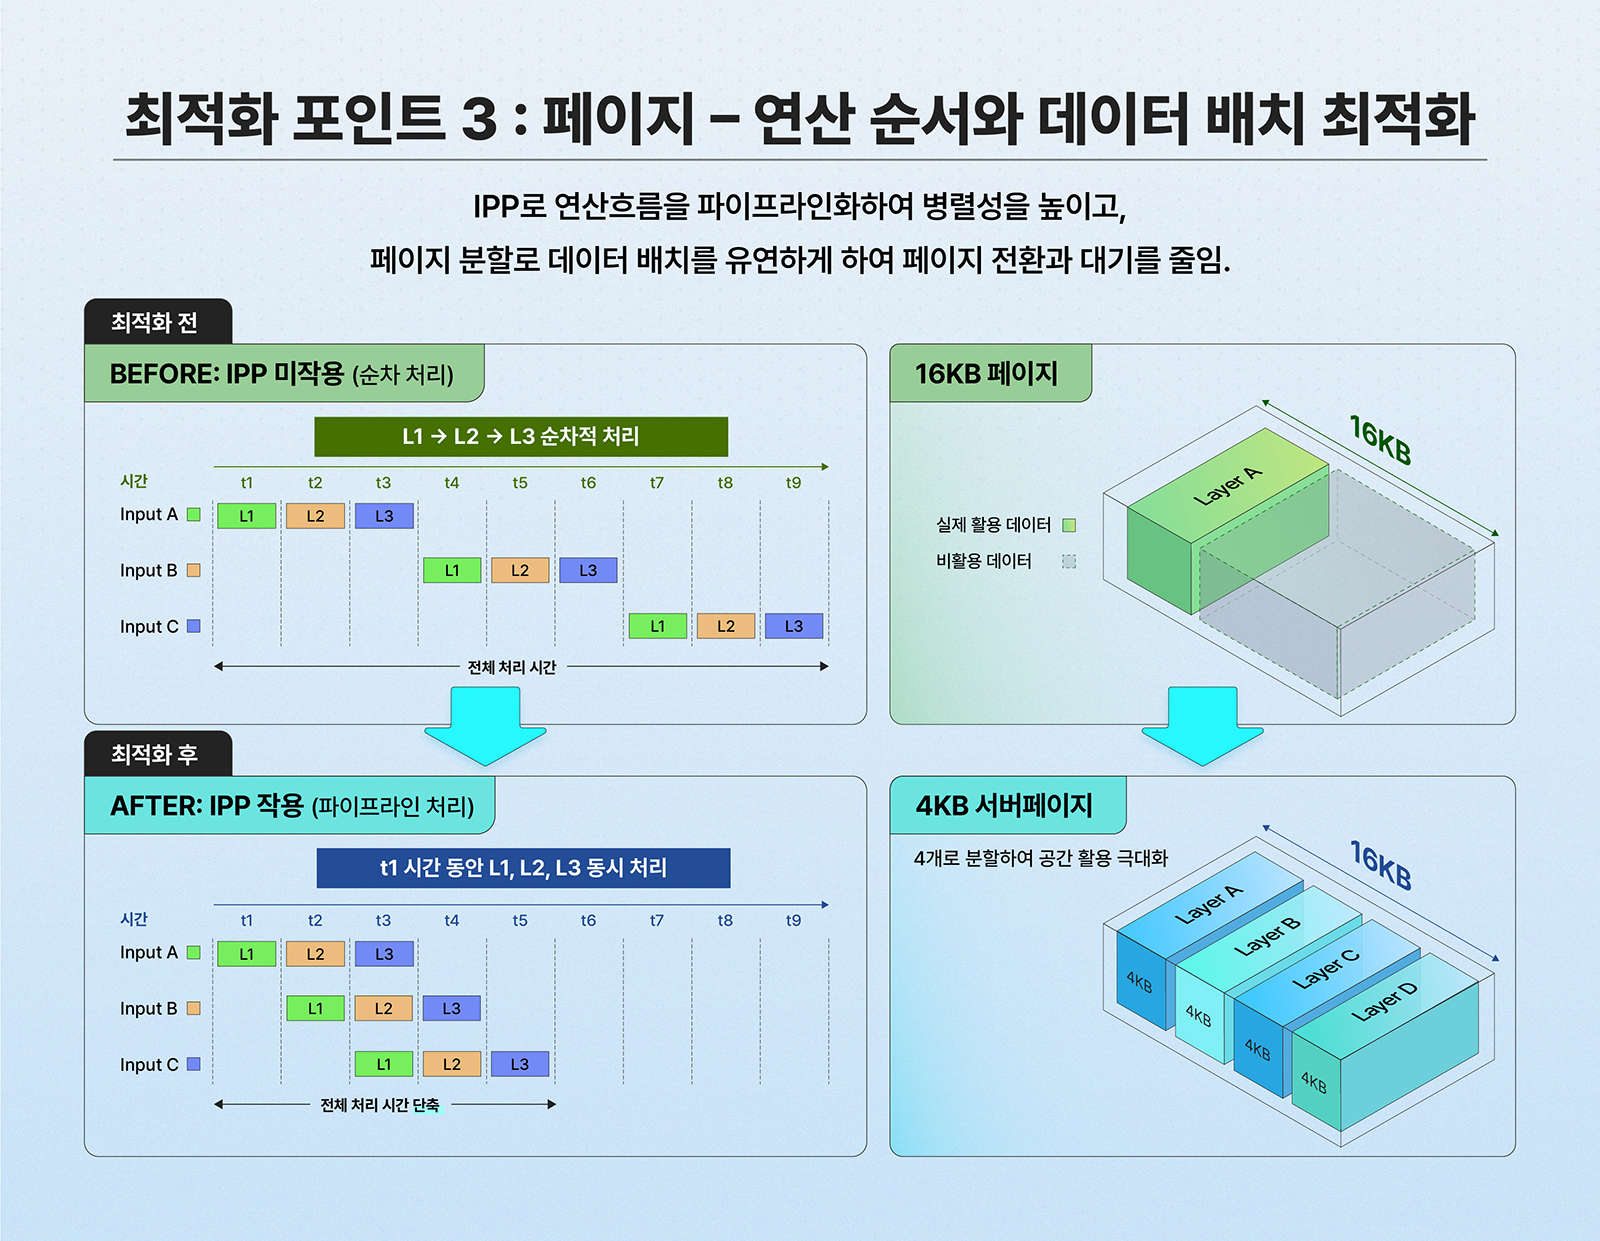
페이지 분할을 적용한 결과, 에너지 효율은 1.2배, 처리량은 1.7배 향상됐다. 다만 페이지 크기가 작을수록 항상 유리한 것은 아니다. 최적 페이지 크기는 신경망 모델에 따라 달랐다. 페이지가 지나치게 작아지면 신경망 레이어가 과도하게 쪼개져 MAC 지연이 오히려 늘어날 수 있기 때문이다.
이 결과는 페이지 최적화가 단순한 메모리 구성 문제가 아니라, AI 모델 구조와 메모리 동작을 함께 맞추는 문제임을 시사한다. 셀은 값을 정밀하게 표현하고, 비셀은 그 값을 효율적으로 선택하며, 페이지는 데이터가 효율적인 순서로 연산에 투입되도록 조정한다. A-CiM의 성능은 이 세 요소가 얼마나 유기적으로 동작하느냐에 달려 있다.
쉽게 이해하기: 국제공항 운영에 비유한 A-CiM 최적화
A-CiM의 핵심은 데이터를 여러 번 옮기면서 생기는 시간과 전력 소모를 줄이는 데 있다. 국제공항 운영에 비유하면, 3D FeNAND는 많은 이용객과 비행 일정을 처리할 수 있는 대형 허브공항에 해당한다. 규모가 클수록 더 많은 데이터를 저장할 수 있지만, 시설이 크다고 처리 속도가 저절로 빨라지는 것은 아니다.
먼저 이용객을 정확히 식별하고 목적지에 맞는 게이트로 배정해야 한다. 이는 하나의 셀이 여러 전류 상태를 안정적으로 구분해 AI 연산에 쓰이는 값을 세밀하게 표현하는 과정과 비슷하다. 이 단계가 정확할수록 이후 흐름도 매끄러워진다.
다음으로 활주로, 유도로, 탑승교 같은 이동 경로가 효율적으로 설계돼야 한다. 이동 동선이 복잡하거나 병목이 생기면 전체 운항이 지연된다. 이는 셀을 선택하고 제어하는 워드라인과 주변 구조의 부담을 줄이는 비셀 최적화에 해당한다. 전류가 오가는 경로를 효율화해야 전력 소모와 지연 시간을 낮출 수 있다.
마지막으로 이착륙 스케줄도 함께 조정해야 한다. 같은 시설 안에서도 운항 순서와 시간 배분이 맞지 않으면 대기 시간이 늘어난다. A-CiM에서도 연산할 데이터를 어떤 순서와 단위로 배치하느냐가 성능을 좌우한다. 결국 3D FeNAND 기반 A-CiM은 셀, 비셀, 페이지가 함께 맞물릴 때 데이터 이동 부담을 줄이고 AI 연산 효율을 높일 수 있다.
미니 인터뷰: 연구자가 말하는 3D FeNAND 기반 A-CiM의 가능성
Q1. 논문에서 제시한 처리량 약 10~20배, 에너지 효율 약 4,000~5,000배 개선은 어떻게 이해하면 되나?
이 수치는 기존 A-CiM 후보로 많이 연구돼 온 2차원 비휘발성 메모리 배열과 비교했을 때, 3D FeNAND의 높은 집적도 장점이 반영된 결과다. 제한된 칩 크기 조건에서 기존 2차원 배열은 저장 용량의 한계로 가중치를 반복해서 다시 불러와야 하고, 이 과정에서 데이터 이동과 재기록 에너지가 크게 발생한다.
반면 3D FeNAND는 더 많은 가중치를 한 번에 저장하고 연산에 활용할 수 있어 재로딩 부담을 줄인다. 그만큼 처리량은 높아지고 에너지 소비는 낮아진다. 같은 면적 안에서 더 많은 연산을 더 적은 전력으로 수행할 수 있다는 점이 이번 성능 개선을 설명하는 중요한 지점이다.
Q2. 연구 과정에서 가장 해결하기 어려웠던 기술적 과제는 무엇이었나?
가장 어려웠던 점은 해결해야 할 과제가 하나의 영역에 머물지 않았다는 것이다. 3D FeNAND 기반 A-CiM의 성능을 높이려면 셀, 비셀, 페이지 방식을 동시에 고려해야 했다. 강유전체 소자, 낸드 아키텍처, AI 워크로드에 대한 이해가 맞물려야 했기 때문에, 특정 분야의 전문 지식만으로는 접근하기 어려운 구조적 과제였다.
이를 해결하기 위해서는 다양한 전문 배경을 가진 연구자들의 협업이 필요했다. 각 영역의 연구자들은 서로의 최적화 결과를 공유하고, 이를 다시 각자의 연구에 반영했다. 그 결과 셀, 비셀, 페이지 방식 전체를 하나의 시스템으로 아우르는 공동 최적화를 달성할 수 있었다.
Q3. 이번 연구가 향후 낸드 기술 발전 방향에 시사하는 점은 무엇인가?
이번 연구는 낸드가 단순한 저장 매체를 넘어 연산 매체로 확장될 수 있음을 시사한다. 특히 강유전체를 활용한 FeNAND는 기존 2차원 비휘발성 메모리 배열과 3D CTN 낸드 대비 높은 에너지 효율을 보이며, 저전력·고효율 A-CiM 플랫폼으로서의 가능성을 뒷받침했다.
이러한 접근은 AI 연산뿐 아니라 메모리 내부 검색 등 데이터 중심 연산 분야로도 확장될 수 있다. 대규모 AI 모델을 위한 초고집적·저전력 메모리 연산 플랫폼이라는 관점에서, 이번 연구는 낸드 기술이 나아갈 수 있는 새로운 방향을 제시한다.